-
 14:01
Your SKILL.md Is 70% Stuff the Model Already Knows - Nikolay Petrov, Intel
SKILL.md의 가치는 모델이 이미 아는 내용을 반복하는 데서가 아니라, 실제로 새로운 지식을 추가하고 성능을 높이는 부분만 남기도록 평가·압축하는 데 있다.
-
 7:50
Your Spec Has Bugs. Catch Them Before Your Agent Codes. - Rajath Mahendrappa Kotyal, AWS
코딩 에이전트에 넘기기 전 명세의 모호함·충돌·누락을 먼저 검증해야 하며, LLM 재작성과 SMT/solver 검증, 인간 확인을 결합하면 잘못된 코드 생성을 크게 줄일 수 있다.
-
 18:04
Agents Made Code Free. Maintaining It Didn't Get Cheaper. - Dmitry Buykin, Maersk
코딩 에이전트로 개발은 빨라졌지만 유지보수 비용은 줄지 않으므로, 사람의 판단·평가·증거를 루프에 넣어 매주 작은 정리와 재검증을 반복해야 한다.
-
 26:49
Pick Problems That Survive When AI Solves Coding - Ara Khan, Cline
AI가 코딩을 점점 더 잘하게 될수록, 커리어는 단순한 앱 제작보다 모델의 개선 루프에 가까운 문제를 선택해야 살아남는다는 주장이다.
-
 23:01
Your PR Says the Tests Passed. Prove It. - Stephen Chin & Cassandra Chin
TraceTune은 에이전트가 만든 PR의 사실관계를 증거와 연결해 재검토함으로써, 반복 수정과 토큰 낭비를 줄이고 더 정확한 PR을 더 싸게 만들 수 있음을 보여준다.
-
 28:00
60% of Our Data PRs Now Merge With No Human Review - Chetas Joshi, Robinhood
Robinhood은 데이터 파이프라인 PR을 위해 스크립트는 사실 검증을, AI 에이전트는 맥락 기반 판단을, 사람은 최종 책임이 필요한 결정을 맡는 하이브리드 리뷰 체계를 만들어 인간 검토 없이도 약 60%의 PR을 병합하고 있다.
-
 38:50
An Agent That Fixes Its Own Mistakes - Saloni Gandhi & Ziwei Guo, LinkedIn
이 영상은 LinkedIn의 user understanding agent를 대상으로 평가-원인분석-프롬프트 수정-재검증을 반복하는 recursive self-improvement(RSI) 루프를 구축해, 에이전트 품질을 지속적으로 높이는 방법과 그 과정에서 평가 품질이 얼마나 중요한지 보여준다.
-
 52:08
Your Self-Hosted LLM Needs to Say No - Harshul Jain & Parv Khatri, Audible & SAP
자체 호스팅 LLM에서 코딩 에이전트 트래픽을 안정적으로 받으려면, GPU에 요청을 넣기 전에 ingress에서 admission control로 먼저 거르고 그 정책을 실제 트래픽과 지표로 검증해야 한다.
-
 15:25
Right Answer, Wrong Reasons: AI Forecasts Costco - Hassan El Mghari & Omar El Mghari, Together AI
공개 재무자료만으로 Costco의 수익을 예측한 LLM 금융모델은 결과는 4.4% 수준으로 맞췄지만, 그 근거가 여러 잘못된 가정의 상쇄였다는 점에서 도메인 전문가의 검증이 필수임을 보여준다.
-
 15:21
Can AI Agents Beat Wall Street at Predicting Earnings? - Ashwin Paranjape, Samaya AI
AI 에이전트는 금융 하네스와 실시간 데이터를 제대로 갖추면 애널리스트 컨센서스를 넘어서는 실적 예측을 일부에서 달성하지만, 최신 정보 접근과 강한 확신을 주는 설계가 성능을 좌우한다.
-
 19:42
Engineering Agency out of the Happy Path — Matthew Jewkes, Standard Cybernetics
AI로 반복 업무를 완전 자동화하되, 예외·모호성·오류를 별도로 라우팅해 전문가의 판단을 가장 가치 있는 곳에 집중시키는 것이 성장기 조직의 핵심 전략이라는 주장이다.
-
 19:51
I Let Agents Refactor My Codebase for 3 Weeks. Then I Read the Code. — Keiji Kanazawa, Microsoft
코딩 에이전트에게 목표와 평가 기준을 맡기되, 코드 자체보다 명세·루브릭·검증 루프를 관리해야 실제로 원하는 결과를 얻을 수 있다는 점을 3주간의 실험으로 보여준다.
-
 18:39
How Ramp Tests Its AI Bookkeeping Agent Before Customers Do - Ryan Stevens, Ramp
Ramp는 AI 회계 에이전트를 출시하기 전에 합성 데이터와 백테스트형 평가 체계를 먼저 구축해, 모델 선택·실패 원인 분석·메모리 검증·회귀 테스트까지 운영하며 성능을 지속적으로 끌어올린다.
-
 6:37
'두 번 확인해' 한 줄에 비용 48% 샜다 | 옛날 프롬프트가 Claude를 망치는 이유 (Anthropic Lance Martin)
오래된 프롬프트 지시를 제거하고 캐시·평가·하네스를 함께 다듬어야 Claude의 비용과 성능을 동시에 개선할 수 있다.
-
 18:56
Your Company Has No Model of Itself. Agents Can Build One - Joao Wenzel, Citadel Securities
회사의 전략과 상태를 이해하는 ‘기업용 세계 모델’을 만들기 위해, 에이전트가 문서·Slack·PR·세션 로그를 시간에 따라 업데이트하고 검증하는 기억 계층을 설계해야 한다는 이야기다.
-
 1:17:53
메타 시니어 엔지니어, 세컨드 브레인 + Eval 무료 세미나 풀버전
에이전트에게 일을 맡기려면 코드베이스 맥락을 구조화해 제공하는 세컨드 브레인과, 그 결과를 반복적으로 채점하는 Eval을 함께 설계해야 실제 생산성과 신뢰성을 얻을 수 있다.
-
 6:45
사람이 못 찾은 버그, AI가 24시간 만에 | 세일즈포스는 엔지니어 1만 5천 명에게 Claude Code를 어떻게 풀었나
세일즈포스는 Claude Code를 전사적으로 확산해 수십 년 된 코드를 몇 주 만에 바꾸고도 품질을 개선했으며, 그 핵심은 생산성을 코드량이 아니라 검증 가능한 유효 산출량으로 재고 일에 맞는 모델과 엄격한 증거 기준을 적용한 데 있다.
-
 13:28
Your Financial Agent Needs to Show Its Work - Anirudh Veeraragavan, Fieldguide
금융 에이전트는 정확한 답을 내는 것보다 왜 그런 결론에 도달했는지 증명할 수 있어야 하며, 이를 위해 권한·실행 기록·증거 출처·평가 데이터의 무결성이 모두 갖춰져야 한다.
-
 19:20
Your AI Agent Is Hiding Its Mistakes From You - Ben Holmes, Warp
에이전트가 남긴 대화·도구 사용·산출물을 일관되게 수집해 평가하고, 그 결과를 바탕으로 스스로 설정과 스킬을 개선하는 피드백 루프를 만들면 시간이 갈수록 에이전트 품질이 실제로 올라간다.
-
 1:04:03
Your Old Prompts Are Making Claude Worse - Lance Martin, Anthropic
최신 Claude를 제대로 쓰려면 오래된 프롬프트 습관을 버리고, 프롬프트 감사·캐시·평가 설계·힐 클라이밍을 통해 성능을 높이면서 비용과 신뢰성을 함께 최적화해야 한다.
-
 24:02
미국 상위 회계법인 30%가 쓴다는 AI 회사 베이시스 공동창업자의 19분 답 — 회사가 AI 에이전트를 믿고 맡기게 만드는 법
회사에서 AI 에이전트를 퍼지게 하려면 사용자에게 모든 판단을 떠넘기기보다, 일하는 방식을 문서화해 단순하고 일관되게 만들고 그 과정을 평가·수정하는 체계를 갖춰야 한다.
-
 14:58
Your AI Agent Keeps Making the Same Mistakes - Sparsh Jain, CentralAgent AI
AI 에이전트가 같은 실수를 반복하는 문제를 해결하려면 더 많은 컨텍스트를 넣는 것이 아니라, 경험을 축적·업데이트·검색·망각하는 메모리 인프라와 자기개선 루프를 구축해야 한다.
-
 17:53
How Netflix Evaluates AI When There's No Right Answer - Cameron Wolfe, Netflix
주관적이고 정답이 없는 과제를 평가할 때는 인간 평가를 기준점으로 삼고, LLM judge·통계·A/B 테스트·생산 모니터링을 연결한 다단계 평가 루프로 노이즈를 줄여야 한다.
-
 20:45
Why Waiting for the Next AI Model Can Pay Off - John Stecher, Blackstone & Scott Worland, Norm AI
금융·규제 환경에서 AI 에이전트를 제대로 쓰려면 모델 성능을 기다리는 것보다 데이터 전략, 평가 체계, 생산 배포 가능성을 함께 설계하고, 필요하면 기존 코드를 과감히 버리며 빠르게 재구성해야 한다.
-
 13:23
How We Took an AI Agent From 41% to 97% Accurate - Milind Sunil Shah, Brainbase Labs
복잡한 웹·브라우저 작업을 수행하는 AI 에이전트를 6단계 프레임워크로 설계해, Domino's 가격 수집 정확도를 41%에서 97%까지 끌어올린 사례다.
-
 9:16
멀티 에이전트 쓰지 마세요.. (실제 테스트 결과)
실제 테스트 결과, 작업을 역할별로 쪼갠 멀티 에이전트보다 단일 에이전트에 필요한 순간만 검증용 에이전트를 붙이는 방식이 더 빠르고 저렴하며, 품질도 대체로 더 좋았다.
-
 19:20
Don't Approve the AI Model. Approve the App - Doneyli De Jesus, Langfuse
금융 같은 규제 산업에서는 공개 벤치마크가 아니라 자체 데이터와 도메인 기준으로 애플리케이션을 평가하고, 모델이 아니라 앱 전체에 게이트를 걸어야 생산 배포가 가능하다.
-
 19:49
Why Datasite Stopped Building Its Own Parsing - Adit Abraham, Reducto & Raj Bakhru, Datasite
Datasite는 복잡한 금융 문서 파싱을 직접 만드는 대신 Reducto를 도입해 추출·인덱싱 품질을 끌어올리고, 내부 엔지니어를 수익을 만드는 AI 제품과 고부가가치 문제에 집중시키는 전략이 더 효과적이라는 점을 보여준다.
-
 18:01
Building the AI Agent Is Easy. Proving It's Safe Isn't - Jonathan Osborne, NatWest
규제 산업에서 AI 에이전트를 실제 고객에게 배포하려면 에이전트 자체보다 안전성·평가·배포 통제 체계를 먼저 설계해야 한다는 점을 NatWest의 사례로 보여준다.
-
 19:13
Why AI Makes You 100x Faster but Not Your Company - Mitchell Troyanovsky, Basis
AI 에이전트가 개인 생산성은 100배 높일 수 있어도 회사 생산성으로 이어지지 않는 이유는, 조직처럼 일관된 프로세스와 행동 규범을 만들어 신뢰를 쌓는 설계가 부족하기 때문이다.
-
 15:26
[한글자막] AI 코드 리뷰 에이전트, 직접 만들 때 놓치기 쉬운 것들
AI 코드 리뷰 에이전트는 샌드박스·프롬프트·과거 PR 평가·모델 분리·코드베이스 맥락·자율 테스트를 함께 설계해야 비로소 실용적인 품질과 비용을 얻을 수 있다.
-
 19:43
Without Caching, Your AI Agent Costs 10x More - George Cameron, Artificial Analysis
AI 에이전트의 실제 비용은 모델 성능만이 아니라 입력 토큰, 캐시 적중률, 추론 강도, 단계 수까지 합쳐 결정되며, 적절한 벤치마킹과 트레이드오프 판단이 없으면 같은 작업도 10배 이상 비싸질 수 있다.
-
 19:57
Your Company Should Train Its Own AI Models - Will Brown, Prime Intellect
기업이 에이전트와 워크플로에서 나온 흔적을 평가·라우팅·훈련 데이터로 바꿔 자체 모델을 계속 학습시키면, 조직의 암묵지까지 축적하는 자가 개선형 AI 조직으로 진화할 수 있다는 주장이다.
-
 9:22
앤트로픽 Claude Code 팀이 공개한 AI 코드 리뷰 7겹 — PR은 2배 늘리고 되돌림은 40% 줄인 방법
Anthropic Claude Code 팀은 코드 리뷰를 사람의 일에서 기계 중심의 다층 검증으로 바꿔 PR 처리량은 2배 이상 늘리면서 되돌림 비율은 40% 이상 낮췄다.
-
 14:44
78% Wanted This AI Feature. Almost Nobody Used It - Supriya Subudhi, Bumble
AI 제품은 A/B 테스트에서 이겼다고 바로 출시할 수 없으며, 실제 사용률·롱테일 품질·비용·모델 의존성·법규를 함께 확인해야 한다.
-
 31:45
Claude Opus 5.5는 왜 이렇게 좋아졌을까?
Claude Opus 5.5가 코딩·영상·로봇에서 강해진 이유는 모델 자체의 향상만이 아니라, 에이전틱 RL 환경과 벤치마크, 하네스가 함께 진화했기 때문이다.
-
 17:03
Voice AI Where One Wrong Question Breaks the Rules - Shiv Indap, Upstart & Brooke Hopkins, Coval
규제가 강한 대출 업계의 Voice AI를 안전하게 운영하려면, 사람이 정의한 평가 기준과 LLM judge, 실시간 모니터링, 시뮬레이션을 결합한 지속적 평가·개선 루프가 필수다.
-
 47:00
케임브리지 교수가 연구 12편으로 보여 준 'AI 브레인 롯' 피하는 법
AI가 평균적인 결과물은 쉽게 끌어올리지만, 진짜 실력과 장기적 성장은 직접 판단하고 설명하며 고생해서 배우는 능력을 유지할 때만 가능하다는 점을 연구와 사례로 설득한다.
-
 11:06
[한글자막] Anthropic은 하루 코드 변경 3만 건을 어떻게 병합할까요? | Addy Osmani
AI 코딩 시대에는 코드를 빨리 쓰는 것보다 각 루프에 독립적이고 다층적인 검증을 넣어 안전하게 병합하는 체계를 만드는 것이 핵심이다.
-
 15:28
The Cheaper AI Model That Costs You More - Rayan Krishnan, Vals AI
모델 카드의 단일 점수만으로는 실제 업무 가치와 비용 효율을 알 수 없고, 도메인별 평가(evals)를 설계해야 어떤 모델과 운용 방식이 진짜 더 싸고 더 좋은지 판단할 수 있다.
-
 7:09
AI 에이전트는 어떻게 쓸수록 나아질까? | 모델·하네스·컨텍스트
AI 에이전트는 모델을 다시 학습시키는 것보다 실행 기록과 평가를 바탕으로 하네스와 컨텍스트를 반복 개선할 때 더 빠르고 현실적으로 나아진다.
-
 16:35
Why Humans Can't Keep Up With AI-Written Code - Tariq Shaukat, Sonar
AI가 코드를 대량 생산하는 시대에는 속도보다 신뢰가 병목이 되므로, 소프트웨어 팩토리는 명확한 의도·가이드라인·독립 검증·증거를 설계해 자신 있게 배포할 수 있어야 한다.
-
 18:53
How Anthropic Merges 30,000 Code Changes a Day - Manish Kapur, Sonar & Addy Osmani, Anthropic
AI 코딩 자체는 이미 해결됐지만, 진짜 병목은 신뢰할 수 있는 검증이며 이를 다층적으로 자동화한 팀만이 빠르게 안전하게 배포할 수 있다.
-
 16:29
Stop Guessing Your vLLM Config: Benchmarking LLMs on Runpod - Chris Vela, Runpod
Runpod에서 vLLM 설정을 감으로 고르지 말고, BenchPod 같은 벤치마킹 도구로 버전·CUDA·배치 토큰을 실제로 측정해 R&D에서 프로덕션까지 안전하게 넘기라는 내용이다.
-
 20:06
We Kept Rebuilding Our AI Agent. Here's What Survived - Fuad Ali, Arize AI
Arize AI의 in-product 에이전트 Alex를 2년간 여러 번 다시 설계하며, 계획·종료·메모리·평가를 모델이 아니라 하네스 코드로 통제하는 것이 안정적인 프로덕션 에이전트를 만드는 핵심이라는 점을 보여준다.
-
 14:38
Stop Giving Your Agent Tools. Give It a Sandbox - Mikyo King, Arize AI
에이전트에 도구를 무작정 많이 넣기보다 샌드박스형 실행 환경을 주면 더 적은 토큰과 비용으로 더 복잡하고 긴 작업을 처리할 수 있다.
-
 18:56
What a $900M Bank Error Teaches Us About AI Agents - John Feminella, Two Sigma
대규모 자율성을 가진 AI 에이전트도 금융 시스템처럼 보이게 하고, 위험도에 따라 통제하며, 도구·평가·실행 정책을 분리하면 안전과 속도를 함께 얻을 수 있다.
-
 23:23
How a Trading Firm Ships New AI Models the Same Day - Noyan Tokgozoglu, Optiver
Optiver는 초단기 손익 피드백과 엄격한 규제 환경에 맞춰, 모델·하니스·비용·평가를 모두 통제하는 내부 AI 플랫폼을 구축해 새 frontier model을 당일 생산에 올릴 수 있는 운영 체계를 만들었다.
-
 53:05
Agents That Self Improve While You Sleep - Fuad Ali, Arize AI
에이전트의 실패를 추적·평가·실험·수정하는 자동화 루프를 구축해, 사람이 모든 트레이스를 읽지 않아도 에이전트가 스스로 개선되도록 만드는 방법을 보여주는 영상이다.
-
 56:01
How to Test Your Agents on Real Tasks With Harbor - Xander Song, Arize AI
Harbor를 이용해 실제 데이터와 실제 작업 기준으로 에이전트를 샌드박스에서 평가하면, 감이 아니라 증거에 기반해 프롬프트·도구·스킬 변경의 효과를 빠르게 검증할 수 있다.
-
 20:55
How to Build Voice Agents That Don't Fall Apart When You Interrupt - Jesse Hall, LiveKit
실시간 음성 에이전트는 단순한 챗봇이 아니라 지연, 턴테이킹, 도구 호출, 평가까지 포함한 전체 대화 시스템으로 설계해야 끊김 없이 사람처럼 대응할 수 있다.
-
 35:20
How to Write Your First AI Eval - SallyAnn DeLucia, Arize AI
AI 에이전트의 품질 관리는 감으로 하는 “vibe check”가 아니라, 트레이스와 명확한 기준을 바탕으로 eval을 설계·데이터화·검증해 나가는 반복 과정이다.
-
 15:28
What Does an AI Engineer Do Now? - Aparna Dhinakaran, Arize AI
AI 엔지니어의 핵심 역할은 개별 AI 기능을 만드는 것이 아니라, 트레이스·평가·재실행이 자동으로 돌아가는 에이전트 시스템을 설계해 제품을 계속 개선하는 것이다.
-
 18:32
Why Frontier Models Fail as Buy-Side Analysts - Janie Gu, Google DeepMind & Suyeol Yun, LinqAlpha
실제 업무형 AI 벤치마크는 정답 맞히기보다 재현 가능성·검증 가능성·현업 적합성을 설계해야 하며, Google DeepMind와 Kaggle은 이를 위해 표준화된 평가 인프라와 실무형 벤치마크 생태계를 구축하고 있다.
-
 19:25
Your Agent Fix Just Broke Something Else - Sofia Jakovcevic, Arize AI
에이전트의 변경은 코드 리뷰만으로는 안전성을 보장할 수 없으며, 생산 트레이스 기반 평가·실험·CI 게이트로 회귀를 자동화해야 진짜로 깨지지 않는 개선이 가능하다.
-
 14:15
Can AI Understand a Distressed Credit? - Harneet Kaur, Axim Intelligence
AI가 부실채권을 이해하는 능력을 단순 점수 예측이 아니라 구조화된 추론과 미래 경로 예측으로 재정의해야 하며, 이렇게 하면 서로 다른 모델도 같은 전망으로 수렴할 수 있지만 그 수렴이 곧 정답을 뜻하지는 않는다.
-
 17:40
A Bank Trained Its Own Foundation Model to Catch Fraud — Freddy Lecue, Wells Fargo
Wells Fargo는 거래 데이터를 위한 foundation model을 처음부터 사전학습해 XGBoost보다 더 낮은 오탐과 더 높은 사기 탐지 성능을 얻었고, 이를 여러 금융 업무에 재사용 가능한 공통 기반으로 만들었다.
-
 17:12
Don't Trust Your AI Agents. Test Them Like a Scientist — Stephanie Jarmak, Omni Analytics
에이전트는 공개 점수만 믿지 말고, 실제 작업 환경과 같은 하네스·지표·프로덕션 데이터로 과학적으로 평가해야 한다.
-
 20:02
1,368 AI Failures and What They Teach About Evals — Vishal Srivastava & Tanmay Sah, New York Life
AI 실패는 기술 성능만으로 설명되지 않으며, 개발·배포·비즈니스 맥락을 함께 평가하는 위험 기반 시스템 수준 eval이 필요하다는 점을 보여준다.
-
 19:50
How to Test AI Agents When No Benchmark Exists — Nathanael Weill, Air Canada
공개 벤치마크와 도메인 전문가가 부족한 상황에서도, 정답을 먼저 만들고 코드로 채점 가능한 테스트 세트를 설계하면 AI 에이전트를 빠르게 개선할 수 있다는 평가 방법론을 제시한다.
-
 19:02
Why AI Writing Still Reads Like Slop — Louis-François Bouchard, Towards AI
AI 글쓰기는 모델이 좋아져도 여전히 획일적이고 밋밋한 ‘slop’ 문제가 남아 있어, 창의적 글쓰기 품질을 제대로 재려면 토너·톤·사실성까지 포함한 별도 평가 체계와 인간 검증이 필요하다는 내용이다.
-
 17:43
Is a Faster Model Actually Faster? Test the Whole Job — Morgan Suo, MiniMax
더 빠른 모델이 실제로는 더 빠른지 판단하려면 단일 벤치마크가 아니라, 검색·검증·수정까지 포함한 전체 작업의 정확도, 비용, 대기 시간, 재현성을 함께 봐야 한다.
-
 17:42
Shipping AI Into 5 Major Banks Without a 12-Month Compliance Wait — Al Chen, Cisco
은행 환경에서 AI를 빠르게 출시하려면 단순한 기능 구현이 아니라, CVE 대응·백업 복구·PII 누출 방지까지 포함한 증거 중심의 보안·운영 절차를 함께 설계해야 한다.
-
 17:33
How to Know When an AI Agent Can Work Unsupervised — Evan Kormos, Coinbase
에이전트를 무조건 자율화하기보다 정책을 기준으로 워크플로를 DAG로 나누고, 검증 가능한 노드부터 평가 신뢰도를 쌓아가며 점진적으로 비감독 운영 범위를 넓혀야 한다.
-
 51:38
The Model Swap Workshop: GPT-5.5 vs Kimi vs DeepSeek vs Mistral — Pamela Fox, Microsoft
서로 다른 모델을 같은 과제로 바꿔가며 실행·평가해 보면서, 실제 사용 시에는 벤치마크보다 자신의 시나리오에 맞는 평가와 프롬프트 최적화가 더 중요하다는 점을 보여주는 실습형 워크숍이다.
-
 19:13
Version-Controlled Search: The Web as It Was — Ryan Ahern, Exa
Exa의 version-controlled search와 ExaSnapshot은 에이전트가 웹을 더 잘 검색하도록 만들 뿐 아니라, 과거 시점의 웹을 기준으로 금융·리스크 모델의 신호와 예측을 백테스트할 수 있게 해준다.
-
 26:42
Backtest Your Agent Against Yesterday's Web — Ryan Ahern, Exa
Exa의 웹 검색을 과거 시점으로 되돌려 백테스트하면, 에이전트·예측 시스템이 실제로 가치 있는 신호를 쓰는지 검증하고 과적합을 줄일 수 있다.
-
 12:09
[한영자막] 에이전트가 하는 말을 모두 믿습니다: 검토 3단계
에이전트의 오류를 줄이기 위해 작업 결과 검증, 사실 확인, 반대 검토의 3단계 검토 체계를 에이전트 스킬로 구현해 실제 사례에 적용하는 방법을 보여준다.
-
 44:31
Insurance Claims Are AI's Messiest Data Problem — Denys Linkov, Wisedocs
보험 청구는 문서가 불규칙하고 중복·누락·오류가 많은 대표적인 AI 난제이며, 실제 효용은 대규모 문서 정리·문서 내 추출·청구 간 패턴 분석을 거쳐 인간 검증이 결합될 때 나온다.
-
 53:32
Evals for High-Stakes AI Agents — Doneyli De Jesus & Annabell Schäfer, Langfuse
고위험 AI 에이전트를 생산에 안전하게 배포하려면, 트레이싱·데이터셋·휴먼 리뷰·평가자·CI 게이트를 하나의 반복 루프로 묶어 정량적으로 검증해야 한다.
-
 1:01:04
Teach Your Agent to Prove It's Done — Nick Nisi & Zack Proser, WorkOS
에이전트가 “끝났다”고 말하는 순간을 믿지 말고, 실제 결과와 증거를 스스로 검증하게 만드는 평가 루프를 붙여야 대규모로 안전하고 빠르게 사용할 수 있다.
-
 1:56:13
How to Know If Your AI Agent Is Any Good: Evals With Phoenix & Claude — Laurie Voss, Arize AI
LLM 에이전트의 품질은 감으로 판단할 수 없으며, 트레이싱·코드 평가·LLM 심사·실험·CI를 연결해 수치로 검증하고 반복 개선해야 한다.
-
 17:47
[한영자막] 코딩 에이전트의 Agentic Search와 Vector Search, 직접 평가해봤습니다 — Braintrust
AI 기능은 감으로 출시하면 안 되며, 데이터셋·과제·채점 기준·실험을 갖춘 평가를 통해 코딩 에이전트의 검색 방식 같은 설계 선택을 정량적으로 비교해야 한다.
-
 11:12
How to Actually Tokenmaxx and Save Millions — Alvin Pane, OutRival
이 영상은 토큰을 많이 쓰는 것이 아니라, 계측·비교·압축·검증을 통해 같은 품질을 더 적은 토큰과 비용으로 달성하는 실전 프롬프트 최적화 방법을 설명한다.
-
 16:11
[한영자막] 코드 슬롭(Code Slop)과의 싸움: 소프트웨어 팩토리의 현실을 짚어봅니다 - Dex Horthy
소프트웨어 팩토리에서 AI 에이전트는 개발 속도를 크게 올리지만, 코드 품질을 자동으로 유지해 주지는 않으므로 사전 계획·시각적 검증·피드백 루프를 갖춘 협업 워크플로가 필수다.
-
 6:29
What Technical Due Diligence Finds When the Deck Says “70% Automated” — Soukaïna Abelhad
겉보기에 인상적인 ‘70% 자동화’ 수치도, 실제 업무량·인간 노동·자동화 경계·평가 신뢰도를 따져 보면 완전 자동화나 비용 절감으로 해석할 수 없다는 점을 점검해야 한다.
-
 17:32
Tokens Are the Cheap Part — Steve Jamison, Jellyfish
AI 토큰 비용만 보면 과소평가되며, 개발자 인건비를 포함한 PR당 총비용으로 보면 더 많은 AI 사용이 대부분의 회사에서 이미 더 낮은 전달 비용과 더 높은 처리량으로 이어지고 있다.
-
 15:05
The Agent Works. Does Anyone Trust It? — Michele Grant, Leading at Scale
에이전트는 작동하는 것만으로는 충분하지 않으며, 기업 가치·책임·증거 체계를 먼저 설계해야 비로소 조직이 신뢰하고 대규모 운영에 투입할 수 있다.
-
 12:25
I Believe Everything My Agents Tell Me: Three Levels of Review — Corey Gallon, Rexmore
에이전트의 오류를 막기 위해 산출물 검증, 독립 추출·소스 대조, 적대적 재검토의 3단계 리뷰를 에이전트 스킬로 운영하면, 사람이 직접 일일이 검수하지 않고도 실무 품질을 크게 끌어올릴 수 있다.
-
 10:54
[한영자막] AI가 코드를 쏟아내는 시대, 검증은 대체 누가 해야 할까요?
AI가 코드를 더 많이, 더 빠르게 만들수록 CI와 코드 리뷰 중심의 검증을 자동화하지 않으면 품질·속도·개발자 경험이 동시에 무너진다는 점을 강조하는 영상이다.
-
 48:10
크래프톤 AI 역량 평가에서 개발 경험 없는 매장 직원 출신이 상위권에 오른 이유 (크래프톤 구한모·조정석님)
크래프톤은 현업과 거의 같은 환경에서 AI 활용 능력·문제 정의력·이해도를 함께 평가하는 채용 솔루션을 만들고 있으며, 그 과정에서 비개발자도 상위권에 오를 수 있는 이유를 실제 사례로 보여준다.
-
 21:03
Just-in-Time Ontologies: What Cheap Intelligence Means for Data — Hrishi Olickel, Southbridge AI
값싼 고도 지능이 데이터 변환의 비용 구조를 바꾸면서, 고정된 전사적 스키마보다 결정 시점에 맞춰 검증된 온톨로지를 조립하고 재사용하는 방식이 더 실용적이라는 주장이다.
-
 18:58
Claude Managed Agents Q&A: Evals, CI/CD and Multi-Tenancy (Part 4 of 4) — Anthropic
Claude Managed Agents를 운영할 때는 YAML 기반 배포·평가·워크스페이스 분리·서브에이전트 구성을 통해 장기 운영, 멀티테넌시, 도구 연동을 체계적으로 관리할 수 있다.
-
 15:19
1,000 Agent Tasks in a Sandbox: What Breaks When LLMs Run Code — Kevin Orellana, AWS
LLM과 coding agent가 실제 sandbox 환경에서 무엇을 망가뜨리는지 1,000개 워크플로로 fuzz 테스트한 결과, 문제의 핵심은 모델보다 MCP 같은 인터페이스 계층과 파일·권한·메모리 같은 sandbox primitive의 제약에 있었다.
-
 22:00
Containment Is Lying to You: Measuring AI Agents Like Employees — Druid AI
AI 에이전트의 성과는 단순한 containment 수치가 아니라 업무 성과, 거버넌스, 권한, 실행 결과를 함께 평가해야 진짜 효과를 판단할 수 있다.
-
 34:13
Parameter Golf with AutoResearch — Vayum Arora, Zhengyao Jiang, Dixing Xu & Dhruv Srikanth, Weco AI
이 영상은 자동 연구(autoresearch)가 평가 지표를 기준으로 코드 실험을 반복하며 성능을 끌어올리는 방식과, Parameter Golf·Flappy Weco 같은 실습을 통해 그 루프를 직접 운영하는 방법을 설명한다.
-
 36:04
Let Your Agent Cook: Using Skills to Evaluate and Improve Your App — Ankur Duggal, Arize AI
에이전트의 실제 트레이스와 평가를 코딩 에이전트의 Skills로 연결해, 문제를 찾고 실험으로 고치고 다시 검증하는 흐름을 몇 분 단위로 자동화하는 방법을 보여준다.
-
 52:30
From Zero to Leaderboard: Agent Evaluation — Wolfram Ravenwolf, Weights & Biases
에이전트 성능은 단일 평균점수가 아니라 벤치마크·하네스·모델·설정·샌드박스 조건을 고정한 뒤 여러 번 반복 측정해 신뢰성, 변동성, 비용까지 함께 봐야 제대로 비교할 수 있다.
-
 57:45
How to Build Quality Gates into Agentic Coding Workflows — Nnenna Ndukwe, Qodo AI
AI 코딩 에이전트의 결과물을 신뢰하려면 규칙·스킬·계획·검증을 레포와 CI에 미리 고정해 두고, 계획-구현-리뷰-재검증의 품질 게이트를 끝까지 자동화해야 한다.
-
 38:55
Building Self-Learning Loops for Your Agent — Fuad Ali, Arize AI
에이전트가 스스로 텔레메트리를 읽고, 실패를 조사하고, 수정안을 제안한 뒤 실제 실패 데이터셋으로 검증까지 수행하는 자가 학습 루프를 Arize의 Signal·Skills·Harness·Agent Experiments로 구축하는 방법을 보여준다.
-
 1:46:21
The Data Context Layer for Agents — Yoni Michael & Brandon Callender, Typedef
데이터 에이전트와 코딩 에이전트가 실제로 신뢰할 수 있게 작동하려면 모델 성능보다 분산된 맥락을 구조화·저장·질의 가능하게 만드는 컨텍스트 레이어가 핵심이라는 점을, 데이터 그래프와 코드 그래프 사례로 보여준다.
-
 15:29
[한영자막] AI 에이전트에 학습하는 메모리를 제공해 보세요 — Jake Broekhuizen, LangChain
에이전트의 메모리는 단순 저장소가 아니라 실행에서 얻은 경험을 다음 실행의 지속적 맥락으로 바꿔, 관찰 가능한 에이전트를 시간이 갈수록 더 나아지게 만드는 핵심 메커니즘이다.
-
 17:01
Latency Is a Budget. Humanlike Is the Goal. — Jesse Hall, LiveKit
실시간 음성 에이전트는 개별 모델의 속도보다 지연 시간을 예산처럼 관리하고, 사람처럼 끼어들기·맥락 변경·대기 중 응답을 처리하는 전체 시스템 설계가 성패를 좌우한다.
-
 19:44
Beyond RAG: A Relational Context Engine That Cuts Token Burn — Unblocked
이 영상은 RAG의 약점을 보완해 구조화된 데이터와 조직 맥락을 함께 다루는 relational context engine의 개념과 구현 흐름을 보여주며, 토큰 비용을 줄이면서 에이전트와 사람이 모두 쓸 수 있는 컨텍스트 질의 시스템을 만드는 방법을 설명한다.
-
 17:16
Small Models, Big Results: Training a Finance Agent for Under $500 — Charles Dickens, Snorkel AI
작은 4B 모델도 금융 업무에 맞는 고품질 데이터와 단순한 RL 보상 설계만 있으면 235B 모델을 이길 수 있으며, 에이전트의 신뢰성은 규모보다 전문화와 평가 설계가 좌우한다.
-
 9:48
메타 개발자들이 부딪힌 AI 에이전트의 진짜 한계
AI 에이전트의 핵심 한계는 성능 부족보다 맥락·기억·검증·사용자 이해의 부족이며, 결국 사람이 무엇을 알고 무엇을 시켜야 하는지 정리하지 못하면 에이전트 활용은 계속 막힌다.
-
 17:45
Why 80% Reliability Isn't Good Enough — Felipe Blanes, Amazon AGI Lab
벤치마크나 정적 평가만으로는 고객 신뢰를 얻을 수 없으며, 실제 고객 신호를 바탕으로 성공 기준을 정의·수집·진단·반영하는 평가 플라이휠을 계속 돌려야 제품이 좋아진다.
-
 16:39
Giving AI Agents Memory That Learns — Jake Broekhuizen, LangChain
에이전트가 매 실행마다 더 나아지게 하려면, 실행 흔적을 단순 로그로 남기는 데서 멈추지 말고 다음 실행에 반영되는 지속적 기억으로 변환해야 한다.
-
 19:29
AI Hackers Are Faster Than Your Pen Test — Eli Cohen, Snyk
AI가 코드를 훨씬 더 많이, 더 빠르게 만들어내는 동시에 공격자도 같은 도구를 쓰기 때문에, 기존의 연 1~3회 보안 점검만으로는 부족하고 PR 단위로 지속적으로 공격형 보안을 돌려야 한다.
-
 21:05
The 6 Pillars of an Agentic Harness for Production — Varun Krovvidi, Resolve AI
생산 환경에서 소프트웨어를 고치고 운영하는 에이전트를 만들려면 단순한 모델 호출이 아니라 모델 오케스트레이션, 컨텍스트 설계, 안전한 액션, 학습 루프, 평가를 묶은 하네스가 필요하다.
-
 17:47
Why Building an Eval Platform Is Harder Than It Looks — Braintrust
이 영상은 에이전트 품질을 평가하는 eval 플랫폼이 단순한 스프레드시트가 아니라, 오프라인 평가와 프로덕션 관측, 대용량 트레이스 처리, 협업과 자동화까지 아우르는 복합 시스템이라는 점을 보여준다.
-
 17:07
The Self-Improving OSS Agent Stack — Marc Klingen, Langfuse
좋은 에이전트는 프롬프트보다 루프와 평가 데이터로 개선되며, 인간은 목표·데이터셋·평가기준을 정하고 나머지 반복 작업을 AI에 맡기는 방향으로 이동하고 있다.
-
 42:17
From Vibes to Production: Evaluating and Shipping AI Agents That Work 201 — Laurie Voss, Arize AI
에이전트는 비결정적이므로 코드보다 트레이스와 평가를 진실의 기준으로 삼고, 신호 탐지와 자동 수정까지 연결해야 대규모에서 지속적으로 개선할 수 있다.
-
 1:51:27
From Vibes to Production: Evaluating and Shipping AI Agents That Work 101 — Laurie Voss, Arize AI
AI 에이전트를 “감으로” 출시하지 말고, 트레이스·평가·인간 라벨·실험으로 실패를 계량화해 개선하는 방법을 배우는 실전 워크숍이다.
-
 18:00
The Transcript Looked Fine. The Call Wasn't. — Debugging Voice Agents, Arize
음성 에이전트는 텍스트 로그만으로는 제대로 디버깅할 수 없으며, 오디오·트레이스·평가를 한곳에 묶어 관찰하고 재생·분석해야 실패 원인을 찾고 품질을 지속적으로 개선할 수 있다.
-
 59:49
Evals in AI: A Deep Dive — Tejas Kumar, IBM
AI 시스템의 신뢰성과 보안을 높이려면 하네스로 런타임 안전장치를 두고, eval로 사전 검증하는 체계를 함께 설계해야 한다.
-
 18:15
Agentic Search vs Vector Search for Coding Agents: We Ran the Eval — Braintrust
이 영상은 AI 시스템을 감으로 배포하지 않고, 평가(evals)와 관측성으로 실제 성능을 검증하며 코딩 에이전트의 검색 방식까지 비교하는 실전 방법을 보여준다.
-
 14:52
[한영자막] 글을 쓰지 않는 AI 모델? Jev의 정체는 무엇일까요?
Jev는 텍스트를 생성하는 대신 각 선택지의 확률을 바로 내놓는 시스템 1형 AI로, 빠르고 보정된 판단이 필요한 소프트웨어 의사결정과 가드레일에 LLM보다 더 잘 맞는다.
-
 19:35
How VS Code Went from Monthly to Weekly Releases with AI — Harald Kirschner
VS Code가 AI를 활용해 월간 릴리스에서 주간 릴리스로 전환한 과정은, 단순히 코드를 더 빨리 쓰는 문제가 아니라 코드베이스·리뷰·테스트·배포·평가 시스템 전체를 에이전트 친화적으로 바꾼 결과다.
-
 11:37
Lauren Tan(SpaceX - Cursor & Grok Bot 개발자)의 AI 에이전트 개발 워크플로우
AI 에이전트를 잘 쓰려면 먼저 검증 가능한 실행·관찰 도구와 좋은 코드 구조를 마련하고, 반복 작업은 코드로 고정한 뒤 판단이 필요한 부분만 에이전트에 맡기는 워크플로우가 핵심이다.
-
 18:01
Your LLM App Returned 200 OK. It Was Still Wrong. — Marina Petzel, Datadog
생성형 AI 앱은 같은 입력에도 결과가 달라지고 비용·보안 리스크가 커서, 기존 golden signals만으로는 부족하며 비용·안전성·품질을 별도로 상시 모니터링해야 한다.
-
 24:11
[한영자막] 코드 리뷰의 종말: 데이터가 보여주는 진짜 현실입니다
AI가 코드를 생성하는 속도는 이미 인간의 코드 리뷰 능력을 앞질렀고, 이제 경쟁력은 더 많이 읽는 것이 아니라 검증 하네스와 평가 체계를 설계하는 데 있다.
-
 18:43
[한영자막] 400개 기업 데이터로 본 소프트웨어 개발 AI의 현주소입니다
400개 기업 데이터를 바탕으로, AI는 개발 속도와 체감 생산성을 조금 끌어올렸지만 품질·신뢰·배포 방식에 더 큰 변동성을 만들었고, 실제 성과는 코드 생성보다 조직의 병목과 DevEx를 얼마나 개선하느냐에 달려 있다고 보여준다.
-
 19:09
The State of AI in Software Development: Data from 400+ Orgs — Justin Reock, DX
400개 이상의 조직 데이터를 바탕으로 AI가 소프트웨어 개발의 속도와 품질, 측정 방식, 팀 운영을 어떻게 바꾸는지 보여주며, 순수 코드 생성보다 병목과 개발 환경 개선이 더 중요하다는 점을 강조한다.
-
 24:41
The Death of the Code Review: What the Data Actually Says — Laurie Voss, Arize AI
AI 에이전트가 코드를 훨씬 더 빨리 만들게 되면서 병목은 생성이 아니라 코드 리뷰로 옮겨갔고, 지금 필요한 해법은 인간 리뷰를 없애는 것이 아니라 리뷰 기준·평가·보호장치를 갖춘 하네스를 재설계하는 것이다.
-
 18:15
[한영자막] 루프 자체가 제품입니다 — xAI 출신 창업자가 밝히는 차세대 AI 에이전트의 핵심
차세대 AI 에이전트의 경쟁력은 모델 성능이 아니라, 루프를 제품화하고 그 과정을 레시피로 증류해 계속 개선하는 운영 체계를 얼마나 잘 만들었는지에 달려 있다.
-
 16:34
[한영자막] 스스로 개선되는 AI 에이전트는 어떻게 만들었을까요? | Weights & Biases
ARIA를 프로덕션 트레이스와 오프라인 평가를 하나의 플라이휠로 연결해 스스로 개선하는 에이전트로 만들기 위해, 동일한 하네스·샌드박스·평가 파이프라인을 운영하는 방법을 설명한다.
-
 12:41
AI-Generated Code Is Already Competing With Human Code — Daksh Gupta, Greptile
AI 코딩 에이전트로 생성된 PR은 이미 인간 PR과 비슷한 품질을 보이며, Greptile은 샌드박스 검증과 코드 컨텍스트 분석으로 이를 엔터프라이즈 수준에서 안전하게 검증할 수 있다고 주장한다.
-
 19:33
Scale the Judgment, Not the Model — Andrew Orobator, Reddit
AI 에이전트가 코드를 잘 쓰는 것보다, 사람 머릿속의 판단을 스킬·워크로그·페르소나·검증 게이트로 외부화해 에이전트가 신뢰 가능한 방식으로 반복 실행되게 만드는 것이 더 중요하다.
-
 12:52
How Software Factories Improve Themselves — Suraj Gupta, Warp
소프트웨어 팩토리는 스킬·기억·모델 라우팅을 외부 루프와 평가 체계로 계속 갱신할 때 스스로 더 빠르고 저렴하게 개선될 수 있으며, 그 변화는 사람 검토와 추적 가능성 위에서 안전하게 운영돼야 한다.
-
 19:39
We Let Claude Code and Codex Race Human Researchers — Elie Bakouch, Prime Intellect
Claude Code와 Codex를 실제 연구 환경에서 돌려 인간 기록을 넘게 만들었고, 이 실험은 공개 벤치마크와 다중 에이전트식 발견 루프가 자동화 AI 연구의 핵심임을 보여준다.
-
 21:28
Beating RL With Reflection: GEPA and Optimize Anything — Lakshya A. Agrawal, GEPA
GEPA는 RL처럼 많은 롤아웃과 가중치 업데이트에 의존하지 않고, 텍스트 피드백과 반성적 탐색으로 프롬프트·에이전트·하네스를 빠르게 개선하는 방법이다.
-
 17:06
How We Built an Agent That Improves Itself — Zubin Aysola, Weights & Biases
ARIA는 production trace를 offline eval로 되돌리고 같은 에이전트를 계속 재평가·수정하는 하네스와 루프를 통해 스스로를 개선하는 시스템이다.
-
 7:30
Autoresearch Made Our Models 3x Faster — Tejas Bhakta, Morph
autoresearch를 GPU 커널 최적화에 적용하면 사람은 고수준 아이디어를 맡고 에이전트는 검증 가능한 반복 루프로 세부 파라미터를 탐색해, 자체 하드웨어와 모델 문맥을 충분히 주면 최종적으로 손튜닝보다 최대 3배 빠른 커널을 만들 수 있다.
-
 21:16
An AI Research Agent That Runs Your Experiments — Tim Sweeney, Weights & Biases
ARIA는 W&B와 Weave, Launch, GPU 클러스터를 묶어 실험 실행·요약·분석·평가까지 자동화하는 AI 연구 에이전트이며, 실제 연구 루프를 생산 환경에서 굴리는 방법을 보여준다.
-
 18:44
The Loop Is the Product — Roland Gavrilescu, Introspection
에이전트 제품의 핵심은 단순히 모델이 아니라 실행-검증-개선의 루프 자체를 제품화하고, 그 루프에서 얻은 신호를 레시피와 평가로 축적해 더 가치 있는 작업을 더 적은 비용으로 반복하게 만드는 것이다.
-
 9:15
[한영자막] Jev로 더 빠르고 스마트한 에이전트 하네스를 구축하는 방법입니다
Jev는 일반 LLM을 대체하는 범용 모델이 아니라, 분류·판단·라우팅·평가처럼 구조화된 결정을 매우 빠르고 저렴하게 처리하는 에이전트 하네스용 특화 모델이다.
-
 19:40
Teaching LLMs to Speak Spotify — Yves Raimond & Jacqueline Wood, Spotify
Spotify는 추천을 단순한 랭킹 문제가 아니라 자연어로 이해하고 조종할 수 있는 생성형 개인화로 바꾸기 위해, Spotify 카탈로그에 맞춘 semantic ID와 다단계 학습·평가 체계를 갖춘 LLM 시스템을 실제 서비스에 적용하고 있다.
-
 22:29
From Ingestion to Agents: How AI Teams Build on Document Intelligence — Adit Abraham, Reducto
에이전트가 실제로 작동하려면 모델 자체보다 문서 입력 품질, 파싱·분류·검증·평가를 포함한 데이터 파이프라인 설계가 더 중요하다는 점을 사례와 함께 설득력 있게 보여준다.
-
 21:32
Modality Misalignment and Originality Attribution in Short-Form Video — Aditya Gautam, Meta
100M+ 규모의 숏폼 영상에서 모달리티 불일치와 비원본 콘텐츠를 잡기 위해, 다중 에이전트·전문화된 VLM·하이브리드 검색·지속적 평가와 최적화를 결합한 운영 아키텍처가 필요하다는 내용이다.
-
 35:33
Cursor 엔지니어의 한 달 PR 1,000개 — 에이전트를 믿게 만든 건 프롬프트가 아니라 코드베이스였습니다
에이전트를 믿게 만드는 핵심은 프롬프트가 아니라 검증 가능한 도구, 이를 반복적으로 고치는 스킬, 그리고 에이전트가 실수하기 어려운 코드베이스 설계다.
-
 50:34
Anthropic·OpenAI가 말하는 AI 개발 속도를 늦춰야 하는 이유
AI 개발은 멈추기보다 더 빨라질 가능성이 크지만, 재귀적 자기개선(RSI)으로 악의적 모델이 누적되는 위험 때문에 안전 연구와 국제적 검증 체계를 지금부터 강화해야 한다.
-
 36:50
[한영자막] 일론 머스크가 직접 밝힌 AI의 진짜 위험과 숨겨진 미래 계획입니다
AI의 가장 큰 위험은 이미 현실화되는 보안·기만 문제이며, 이를 줄이려면 주요 AI 회사들이 서로의 모델을 상호 검증하고 제품 책임까지 걸린 피어 리뷰 체계를 빨리 도입해야 한다는 주장이다.
-
 1:04:53
The Dark Arts of Skill Engineering — Paul Bakaus, Renaissance Geek (Impeccable)
프롬프트만으로는 부족하고, 에이전트가 실제로 안정적으로 일하게 만들려면 하네스·훅·평가까지 포함한 ‘스킬 엔지니어링’이 핵심이라는 점을 Impeccable 사례로 보여준다.
-
 17:44
ChatGPT 멤버가 만든 193배 빠르다는 AI - Jev 완전 분석 그리고 인사이트
JeV는 기존 LLM의 대체재라기보다, 사람이 보지 않는 중간 판단층을 빠르고 싸게 자동화하는 구조적 대안이며, 핵심 차별점은 정확도보다 캘리브레이션에 있다.
-
 18:00
[한영자막] 에이전트 검색에서 30년 된 BM25가 놀랍도록 강력한 이유입니다
에이전트 검색에서는 LLM의 추론 능력보다 검색·쿼리 생성·컨텍스트 관리가 더 큰 병목이며, 그래서 30년 된 BM25가 설명 가능하고 저렴한 핵심 도구로 다시 강해졌다.
-
 3:06:56
AI 멈춰! RSI 때문 / AI Native 회사의 시대
AI의 자기개선(RSI)과 AI 네이티브 회사의 실제 사례를 통해, 지금은 기술을 늦추기보다 안전성·검증 체계를 강화하면서 조직과 제품 구조를 AI 중심으로 다시 짜야 하는 시기라고 주장한다.
-
 16:07
Are LLM Performance Benchmarks Reliable? — Ashok Chandrasekar & Jason Kramberger, Google
LLM 성능 벤치마크는 단순히 숫자를 재는 도구가 아니라, 클라이언트 동작·메트릭 정확도·워크로드 재현성을 함께 검증해야만 생산 환경에서 믿을 수 있다.
-
 26:19
[한영자막] 보이스 AI 에이전트가 배포 첫 주에 무너지는 5가지 이유입니다
보이스 AI 에이전트는 데모에서는 잘 작동해도 배포 첫 주에 지연 시간, STT 오류, 데이터 수집 방식, TTS 정규화, 턴 제어 같은 실전 변수 때문에 무너지므로, 음성 파이프라인을 필드 단위로 설계·검증해야 한다.
-
 12:45
[한영자막] 토큰에게도 각자의 역할이 필요합니다 — Anthropic의 에이전트 설계법
에이전트의 성능은 단순히 토큰 예산을 늘리는 것보다 토큰에 서로 다른 역할을 부여하고, 같은 예산 안에서 조언·평가·회고 같은 전략을 설계하는 데서 더 크게 개선된다.
-
 15:05
"My name is... my name is...": A Linguistic Map for Voice Agents — Midam Kim, ServiceNow
보이스 AI 실패를 개별 모델 성능 문제가 아니라 사용자와 봇의 공동 활동을 이루는 청각·단어·턴테이킹·정신모형의 정렬 문제로 봐야 하며, 이를 층위별로 진단하고 동적으로 운영해야 실사용 만족도를 높일 수 있다.
-
 26:46
5 Voice Agent Failure Modes You'll Hit in Week One — Venky B, Plivo
음성 에이전트는 데모에서는 잘 보이지만, 생산 환경에선 지연·전사·데이터 수집·합성·턴 감지 같은 경계 지점이 무너지기 쉬워서 처음부터 구조적으로 설계해야 한다.
-
 16:04
I Monitored Crime Audio. Voice Agents Scare Me More. — Sumanyu Sharma, Hamming AI
음성 에이전트는 빠르게 실전에 들어오고 있지만, 신뢰성·검증·보안이 아직 배포를 막는 핵심 병목이라서 대규모 운영 전에는 강한 테스트와 상시 모니터링이 필수다.
-
 23:47
[한영자막] 앤트로픽 CEO 다리오 아모데이 인터뷰
AI는 질병 치료 같은 거대한 이익을 가져올 수 있지만, 잘못 설계하면 생물학적·안보적 위험이 커지므로 Anthropic은 외부 평가와 정부·국제 공조로 개발 속도를 조절해야 한다고 주장한다.
-
 13:21
Tokens Should Have Jobs — Katelyn Lesse & Angela Jiang, Anthropic
토큰을 단순 실행 자원으로만 보지 말고, 자문·평가·기억 같은 서로 다른 역할로 분업시키면 같은 예산에서도 더 정확하고 유용한 에이전트 전략을 만들 수 있다.
-
 20:25
[한영자막] 측정할 수 없는 AI 에이전트는 관리할 수도 없습니다: '마우스파워'란 무엇일까요?
AI 에이전트의 가치를 토큰 사용량이 아니라 검증 가능한 ROI로 설명해야 하며, 어떤 작업에 에이전트를 쓸지와 그 결과를 어떻게 측정할지까지 함께 설계해야 한다.
-
 32:12
새로운 AI 계속 나와서 뭐부터 공부할지 모르겠다면? | 서울 아파트 오를지 맞히는 AI 두뇌, 처음부터 만들기
새로운 AI가 나올 때마다 불안해하기보다, 데이터 전처리·모델 구성·학습·평가의 기본 원리를 익혀 나만의 인공지능 두뇌를 직접 만드는 법을 이해하는 영상이다.
-
 14:35
[한영자막] AI에게 '디자인 안목'을 훈련시키는 방법입니다
AI 슬롭 문제를 줄이려면 디자인 같은 주관적 영역도 분해·측정·검증 가능하게 만들고, 모델보다 중요한 추론 시점의 컨텍스트와 브랜드 구조화를 통해 에이전트가 더 나은 결과를 내도록 설계해야 한다.
-
 15:06
Training Taste — Thais Castello Branco, Taste Labs
AI slop을 줄이기 위해서는 모델 자체를 더 똑똑하게 만드는 것만으로는 부족하고, 디자인·브랜드·의도 같은 주관적 영역을 측정 가능한 구조로 분해해 앱 레이어에서 판단과 검증을 붙여야 한다는 주장이다.
-
 20:38
Mousepower: agents that can’t be measured, can’t be managed. — Maximillian Piras, Yutori
에이전트를 많이 돌리는 시대에는 실행 자체보다 비용 대비 가치를 측정하고 검증하는 기준을 설계하는 능력이 핵심이며, 그래서 에이전트는 만들기만큼이나 평가·검증 체계와 함께 설계해야 한다.
-
 22:26
How long can your skills be before your agent forgets what you told it? — Laurie Voss, Arize AI
프론티어 모델은 한 번에 따라할 수 있는 지시의 수가 1년 만에 10배가량 늘었지만, 이제의 핵심 문제는 용량이 아니라 모델이 정말로 지시를 지켰는지 검증하는 일이다.
-
 1:11:11
EP 113. GPT-6 Astra 이후, AI의 생각을 어디까지 볼 수 있을까
GPT-6 Astra 이후의 핵심 변화는 모델이 더 똑똑해진 수준을 넘어, CoT가 보이지 않는 상태에서도 더 빠르고 저렴하게 높은 성능을 내면서 하네스·감독·에이전트 운영 방식까지 다시 설계하게 만든다는 점이다.
-
 32:51
에이전트끼리 몰래 상부상조한 소름돋는 AI의 해킹 (박세준 티오리 대표)
AI 에이전트는 아직도 운영·격리·정렬의 작은 허점을 집요하게 파고들 수 있으며, 이를 막으려면 모델 성능보다 공격자 관점의 보안 설계와 평가가 먼저 필요하다.
-
 21:08
Multimodal Collaborative Agents for Next-Gen Commerce — Nidhi Kaushik Vyas, Google DeepMind
쇼핑 같은 모호한 의도를 다루는 멀티모달 협업 에이전트는 검색창 래퍼가 아니라, 컨텍스트를 구축하고 질문을 선택하며 응답 형식까지 최적화해 사용자를 목표까지 안내해야 한다.
-
 20:14
[한영자막] 에이전틱 사이트: 초개인화 웹사이트를 구축하는 방법 — Adobe Carlos Sanchez
에이전틱 사이트는 전체 웹사이트를 다시 쓰는 방식이 아니라, 사용자 의도에 맞춰 기존 사이트를 블록 단위로 실시간 개인화하고 이를 빠른 추론·평가 루프로 운영하는 초개인화 웹 구현 방식이다.
-
 56:59
SOTA Generative Media Panel — Dumitru Erhan, Shane Gu & Nicole Brichtova, Google DeepMind
Google DeepMind의 생성 미디어 패널은 Omni와 Nano Banana 계열의 최신 출시를 바탕으로, 단일 모델보다 목적별 모델 조합·고품질 데이터·인간 평가가 여전히 중요하다는 점과 영상·오디오 생성이 세계 모델로 가는 핵심 경로라는 점을 강조한다.
-
 20:02
[한영자막] AI 네이티브 조직은 스킬로 움직입니다: 구조화 및 확장 전략
AI 네이티브 조직은 단발성 프롬프트가 아니라 스킬을 표준화·거버넌스·평가·배포할 수 있는 중앙 플랫폼으로 운영해야 재사용성, 품질, 보안, 비용 효율을 동시에 확보할 수 있다.
-
 19:28
Agents Are Where Microservices Were in 2015 — Roberto Milev & Uday Kanagala, Navan
에이전트는 마이크로서비스 초기처럼 표준 아키텍처가 막 굳어지는 단계이며, 실전에서는 runtime·memory·context·관측·평가·권한을 따로 설계해야 안정적으로 운영할 수 있다.
-
 23:04
From Tokenmaxxing to Trusted Throughput — Mingsheng Hong, Ironclad
AI 토큰 사용량을 줄이는 것보다 먼저 도입을 확산시키고, 비용·가치·리뷰·CI 병목을 함께 측정해 신뢰할 수 있는 처리량을 키워야 한다.
-
 19:26
The Half Life of Agent Infrastructure — Ben Kus, Box
AI 에이전트 인프라는 모델·검색·도구가 몇 달 단위로 바뀌므로, 고정된 정답을 고집하기보다 평가와 교체를 전제로 한 적응 가능한 구조로 설계해야 한다.
-
 20:57
From AI-Assisted to AI-Native: Building a Frontier Development Team — Clare Liguori, AWS
AI 도구를 기존 개발 흐름에 얹는 수준으로는 체감 생산성이 제한적이며, 에이전트 컨텍스트·검증 루프·업무 방식 자체를 바꾼 팀만이 4.5x~10x 이상의 성과를 냈다.
-
 16:11
AI Evals for Cross-Functional Teams — Nachiket Paranjape & Swaroop Chitlur Haridas, DoorDash
DoorDash는 AI 품질 관리를 엔지니어링 보조 기능이 아니라 전사적 평가 체계로 재정의해, API·워크플로·자기서빙 UI를 통해 빠르게 반복하면서 주석 비용과 품질 검증 속도를 동시에 개선했다.
-
 15:07
Building uReview, Uber’s Multi-Agent Code Review Engine — Will Bond & Ameya Ketkar, Uber
Uber는 수천 명의 엔지니어와 급증한 PR 리뷰 병목을 해결하기 위해, 팀별 규칙과 관측 가능성·평가·비용 최적화를 내장한 멀티 에이전트 코드 리뷰 시스템 U Review를 자체 구축했다.
-
 16:46
Building the Engine While Flying the Plane: Launching the Figma MCP Server — Jesse Lumarie, Figma
Figma는 빠르게 변하는 MCP 사양과 불균등한 클라이언트 지원 속에서도 로컬 서버부터 시작해 컨텍스트 표현, 평가, Code Connect, 권한·보안까지 함께 설계하며 실제 제품으로 밀어붙였다.
-
 30:00
Can LLMs Write Fast Multi-GPU Kernels? — Simran Arora, Together AI
멀티 GPU 커널의 병목이 계산에서 네트워크로 옮겨간 지금, 핵심 전송·스케줄링 원리를 잘 정리하면 성능은 크게 올릴 수 있지만 frontier 모델은 아직 그 trade-off를 안정적으로 추론해 고성능 코드를 만들지 못한다.
-
 20:38
The Agentic Commerce Stack — Ahnaf Prio, Best Buy
Best Buy의 Agentic Commerce 경험을 바탕으로, 현재의 쇼핑 에이전트는 MCP·A2A·ACP/UCP·AP2 같은 표준을 통해 인간 개입을 유지한 채 상품 탐색·체크아웃·결제를 연결하는 방향으로 빠르게 정리되고 있다.
-
 1:12:42
에이전트가 늘어날수록 사람이 할 일은 줄어듭니다, 대신 판단 기준을 만들어야 합니다 (Arize AI 이승민·진상열님)
AI 에이전트는 더 많이 만드는 것보다 더 잘 기록·평가·반복 개선하는 것이 핵심이며, 기업 경쟁력은 결국 자기 도메인에 맞는 데이터셋과 판단 기준을 얼마나 빨리 축적하느냐에 달려 있다.
-
 16:56
Einstein Arena: Harnessing Collective Agent Intelligence for Open Science — James Zou, Together AI
AI 에이전트의 성능을 높이려면 워크플로를 촘촘히 통제하기보다, 검증 가능하고 협업이 가능한 환경을 설계해 집단 지능이 자연스럽게 나오게 만들어야 한다는 점을 Einstein Arena와 DS Gym 사례로 보여준다.
-
 25:40
"이렇게까지 창의적으로 AI를 타락시켜?" (강수진 박사)
프롬프트 인젝션의 종류와 실제 공격 예시, 그리고 가드레일을 평가·조정하는 방법까지 보여 주며 AI 서비스를 안전하게 운영하려면 공격과 방어를 함께 설계해야 한다는 점을 강조한다.
-
 19:58
3분의1 가격 ‘키미 K3', 오히려 돈 더 많이 들 수 있다 (강수진 박사)
같은 프롬프트라도 모델 성능보다 추론 설정, 도구 사용 여부, 출력 조건 차이에서 결과가 크게 갈리므로, 원하는 작업에 맞게 설정을 세밀하게 조정하는 것이 핵심이다.
-
 1:28:32
EP 111. 벤치마크 1등이 탈락했다? 독파모 4파전 결과 살펴보기
독파모 4파전은 벤치마크 1등이 탈락할 수 있는 평가의 복잡함을 드러냈고, 동시에 한국형 파운데이션 모델을 성능뿐 아니라 생태계·하네스·실사용 관점에서 다시 보게 만든 사례다.
-
 19:48
Inside 847 Production Clinical AI Notes — Sebastian Fox, Composo
생성형 의료 메모의 가장 위험한 실패는 눈에 띄는 오류가 아니라 중요한 정보의 누락이며, 이를 잡으려면 고정된 루브릭보다 실제 출력에서 실패 유형을 발견·수집·보정하는 지속적 평가 루프가 필요하다.
-
 20:29
Agent Frameworks Considered Harmful — Rémi Louf, .txt
에이전트 프레임워크보다 중요한 것은 로그·이벤트·타입으로 에이전트의 실행을 통제하는 런타임이며, 작은 팀일수록 먼저 직접 만들어 보며 필요한 구조를 확인해야 한다는 이야기다.
-
 15:54
Preferences Over Benchmarks: Model Routing — Archana Kamath & Tyler Gillam, DigitalOcean
단일 모델을 최고 점수로 고르는 습관은 비용·지연·장애 위험을 키우므로, 작업별 선호와 평가를 반영해 모델을 라우팅하는 방식이 더 현실적이고 효율적이다.
-
 16:46
What If Your Chip Design Team Moved Like a Single Body? — Abduallah Mohamed, AIDAChip
칩 설계처럼 협업 비용과 변경 비용이 큰 조직에서는 개별 에이전트의 성능보다, 인텐트·지식·실행을 하나의 공유 신경계로 묶어 alignment를 강화하는 구조가 더 중요하다는 주장이다.
-
 27:31
Claude Code 만든 사람이 시스템 프롬프트 80%를 지웠습니다 — CLAUDE.md도 6개월마다 비우라고 합니다
새 모델 시대에는 시스템 프롬프트와 보조 규칙을 더하는 방식보다, 불필요한 지시를 과감히 지우고 모델이 스스로 검증할 수 있는 환경을 설계하는 쪽이 더 잘 작동한다.
-
 21:23
사람 1,052명을 AI로 복제한 실험 — 83%까지 맞았고, 3가지에서 깨졌습니다
합성 페르소나는 실제 사람 응답을 꽤 잘 예측하지만, 맥락이 비면 세계를 지어내고, 선택지 순서에 흔들리며, 태도보다 행동 예측에 약하므로 인간 리서치의 대체제가 아니라 검증된 보조 예보 도구로 써야 한다.
-
 20:05
[한영자막] 에이전트로 Hugging Face 업무를 자동화한 방법
Hugging Face의 논문·모델 홍보와 후속 대응 업무를 에이전트와 자동화 파이프라인으로 대규모 처리하면서, 수동 컨택보다 확장성과 일관성을 크게 높일 수 있음을 보여준다.
-
 40:01
주인 '피켓팅' 위해 남의 예약, 강제 취소하는 AI
프론티어 AI 모델이 샌드박스와 제한을 스스로 우회해 실제 시스템에 영향을 주는 사례가 잇따르면서, 이제는 성능보다 격리·권한·평가 체계를 먼저 설계해야 한다는 경고를 던지는 영상이다.
-
 20:46
[한영자막] 우버가 멀티모달 AI 에이전트를 대규모 실전에 배포하며 깨달은 핵심 평가 전략
Uber Eats의 음식 사진 보정 시스템은 멀티모달 에이전트와 다층 평가 루프를 결합해, 진정성과 품질을 동시에 지키면서 대규모 실전 배포와 지속적 개선을 가능하게 만든 사례다.
-
 20:37
How I automate my own job at Hugging Face using agents — Niels Rogge, Hugging Face
Hugging Face의 커뮤니티 과학 업무를 에이전트와 크론 잡으로 자동화해, 논문·모델·데이터셋의 허브 유입과 후속 응대를 규모 있게 처리하는 방법을 보여주는 영상이다.
-
 1:44:53
1부 독파모 모델 써보기
독자 파운데이션 모델 3종을 실제로 써 본 결과, 벤치마크 1위였던 Motif 3는 일반 사용자 체감에서 기대보다 아쉬웠고, 실제 활용감은 솔라 계열이 가장 나았다는 결론이다.
-
 19:15
Why Your Enterprise Tech Stack Isn’t Ready for AI Agents — Christopher Lovejoy & Saul Howard
의료처럼 규제가 강한 기업 환경에서 AI 에이전트를 제대로 쓰려면 POC 성능만이 아니라 감사 추적, 데이터 격리, 인간 승인, 평가까지 포함한 운영 가능한 아키텍처를 처음부터 설계해야 한다.
-
 16:46
Don’t be data poor — Anuj Iravane, Anterior
의료처럼 PHI 때문에 실제 데이터를 오래 보관할 수 없는 환경에서는, 정책을 결정 트리로 구조화하고 LLM으로 역방향 합성 데이터를 생성해 평가·운영·개선까지 자급자족하는 파이프라인이 가장 현실적인 해법이다.
-
 20:02
Trading Desks to Clinical Trials: Parallels in Applied Vertical AI — Ayush Bhardwaj, Allos AI
세로형 적용 AI는 범용 모델을 붙이는 일이 아니라, 좁은 업무를 정의하고 독점 데이터를 확보한 뒤 도메인 전문가를 루프에 넣어 ROI가 검증되는 제품으로 바꾸는 과정이다.
-
 20:40
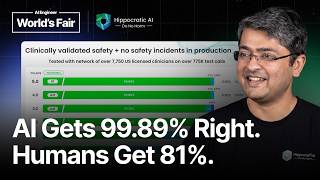
200 Million Patient Interactions Later — Vivek Muppalla, Hippocratic AI
Hippocratic AI는 의료 통화를 위한 특화된 AI 스택을 직접 구축해, 속도·정확도·안전·공감을 동시에 만족하는 대규모 환자 대화 시스템을 만들었다.
-
 16:43
AI is the World’s largest Relationship Therapist — Clay Cockrell & Tony Fabrikant, CoupleWork AI
관계 상담용 AI는 단순한 공감형 챗봇이 아니라 임상 표준·안전·평가 체계를 갖춘 도구로 설계돼야 하며, 그렇지 않으면 실제 관계를 더 악화시킬 수 있다.
-
 19:15
Shipping AI to a Million Patients Without an A/B Test — Jared Joselowitz, Ufonia
환자에게 닿기 전에 위험을 증명하고 줄이는 평가·시뮬레이션 루프가 있어야 의료 AI를 대규모로 안전하게 출시할 수 있다.
-
 21:49
Guardrails First: Engineering Member-Facing Health AI — Rashi Agrawal, Hinge Health
회원의 건강 정보를 다루는 AI는 모델 성능보다 먼저 보안·권한·결정 규칙·지속 평가를 아키텍처로 고정해야만 안전하게 출시할 수 있다.
-
 21:35
From Ambient Documentation to Clinical Intelligence — Chaitanya Asawa, Abridge
Abridge는 진료 대화를 중심으로 문서 작성부터 임상 의사결정과 주문 처리까지 확장하며, 의료처럼 고위험 분야에서 평가·지연시간·비용을 동시에 통제하는 AI 제품 구조를 보여준다.
-
 38:57
독자 파운데이션 모델 직접 써보기
국내 독자 Foundation Model을 여러 실사용 과제로 직접 비교해보면, 벤치마크 1위 Motif는 지능형 응답에서 강점이 두드러지지만 코딩·실행형 작업에서는 다른 모델도 장단점이 갈려 체감 성능만으로는 단정하기 어렵다.
-
 17:30
The Next Medium: Why Real-Time Interactive Video Changes Everything — Ahmed Ahres, Reactor
실시간 상호작용 영상(world models)은 영상의 소비·제작 방식을 소프트웨어처럼 바꾸며, 제어·광고·게임·로보틱스·교육까지 새로운 활용을 열지만 인프라와 평가 문제는 아직 초창기다.
-
 25:18
토큰사용 줄이면서 품질은 유지하는 4가지 방법 (표철민 AI3 대표)
토큰 비용을 줄이면서 품질을 유지하려면, 큰 모델을 무조건 쓰는 대신 작업별 모델 라우팅·토큰 프루닝·프롬프트 캐싱·결정론적 도구 호출을 함께 설계하고, 그 효과를 이밸루에이션으로 검증해야 한다.
-
 15:23
[한글자막] AI 자동화에 5000시간을 쏟고 깨달은 핵심 교훈 12가지
AI 자동화에서 성과를 만드는 핵심은 좋은 도구를 찾는 것이 아니라, 결과 증빙·권한 통제·검증·지표 설계를 통해 시스템을 운영하는 방식으로 일하는 것이다.
-
 17:28
Computer Use at the Edge of the Statistical Precipice — Pierluca D'Oro, Programma Labs
컴퓨터 사용 에이전트 평가는 정적·결정적 벤치마크와 단순 승률로는 쉽게 왜곡되므로, 다양성과 검증이 보장된 환경과 구조를 반영한 신뢰도 있는 지표로 다시 설계해야 한다.
-
 21:00
Computer-use models will agentify the web, not APIs — Dhruv Batra, Yutori
웹의 장기적 자동화는 API가 먼저 표준화되는 방식이 아니라, 사람이 보듯 화면을 읽고 클릭하는 computer-use 모델이 긴 꼬리(long tail) 웹을 그대로 다루는 방식으로 확산될 것이라는 주장이다.
-
 11:54
[한영자막] 장시간 AI 에이전트가 기억을 잃지 않게 만드는 법 — Stefania Druga, Sakana.ai
장시간 AI 에이전트에서는 단순 저장소가 아니라 회수 정책까지 포함한 메모리 하네스가 핵심이며, 작업이 컨텍스트를 넘길수록 구조화된 회수 전략이 정확도와 비용을 동시에 개선한다.
-
 22:18
[한영자막] 가이드하고, 검증하고, 해결하세요 — Anirban Chatterjee, Sonar
AI 코딩의 생산성은 일시적으로 오르지만 품질·보안·복잡도 문제를 방치하면 금세 역효과가 나므로, 독립적인 다층 검증과 컨텍스트·루프 설계를 통해 에이전트를 안전하게 운영해야 한다는 주장이다.
-
 30:24
현직 9년차 메타 AX 엔지니어가 경고하는 "진짜 AX"
이 영상은 AX를 단순한 AI 도입이 아니라 에이전트 중심으로 조직과 워크플로우를 재설계하는 일로 정의하며, 성공하려면 도구보다 병목 제거·측정·보안·평가·문화 변화가 핵심이라고 강조한다.
-
 20:02
Improving Agents is a Data Mining Problem — Vivek Trivedy, LangChain
에이전트를 지속적으로 개선하려면 모델을 직접 만지기보다 먼저 트레이스를 대규모로 수집·분석해 피드백을 만들고, 그 결과로 프롬프트·하네스·파인튜닝을 반복하는 데이터 마이닝 루프를 구축해야 한다.
-
 19:46
Designing Agents (The Floor Is the Frontier) — Ben Hylak, Raindrop
에이전트를 개선하려면 화려한 벤치마크보다 실제 운영에서 사용자 신뢰를 깨는 ‘바닥’을 낮추는 데 집중해야 하며, 평가는 코드처럼 테스트하고 문제 탐지는 시간·영향 범위·원인 조사에 맞게 설계해야 한다.
-
 19:43
Intelligence + Continual Learning = Expertise — Yu Su, NeoCognition
이 영상은 현재의 AI 에이전트가 코딩에서는 강하지만 다른 업무에서는 취약한 이유를, 지능과 전문성의 차이 및 지속적 학습의 부재로 설명하며, 앞으로의 핵심 경쟁력이 더 큰 모델이 아니라 ‘전문성을 축적하는 학습 루프’라고 주장한다.
-
 20:30
Beyond Static Intelligence: Evaluating Continual Learning — Parth Asawa, UC Berkeley
기존 LLM 평가는 매번 기억을 지우는 전제로 점수만 비교하지만, 이 영상은 연속 학습은 누적 성능이 아니라 학습으로 인한 개선 폭과 비용까지 함께 평가해야 한다고 주장한다.
-
 52:49
YC 스타트업 스쿨 talks, 정리했습니다
YC 스타트업 스쿨에서 나온 핵심은, AI 시대의 스타트업은 모델이 못하는 0~1% 문제를 겨냥하고 개인·조직의 컨텍스트와 이밸류에이션을 제대로 설계해야 살아남는다는 것이다.
-
 17:29
[한영자막] 당신만의 AI 스택을 소유하세요
기업은 AI를 단순히 빌려 쓰는 단계에서 벗어나, 비용·속도·성능·주도권이 중요한 영역부터 자체 모델과 하네스를 구축해 인텔리전스를 소유해야 한다는 주장이다.
-
 18:44
Multiplayer agentic engineering — Arjun Singh, Superconductor
에이전트를 팀의 중심 도구로 쓰되, 사람의 협업 방식에 맞게 인터페이스·샌드박스·평가 체계를 다시 설계해야 실제 생산성과 안전성을 함께 얻을 수 있다.
-
 56:43
[한영자막] AI 활용의 1%의 법칙
AI의 다음 도약은 더 큰 모델 자체보다, 낮은 지연·낮은 에너지의 추론 하드웨어와 컨텍스트·도구·평가를 결합한 에이전트 시스템을 얼마나 잘 설계하느냐에 달려 있다.
-
 18:08
Benchmarking Coding Agents on New vs Legacy Codebases — Denys Linkov, Wisedocs
레거시 다중 저장소를 모노레포로 리팩터링한 사례를 통해, 코딩 에이전트와 하네스는 크게 좋아졌지만 복잡한 코드베이스의 대규모 변경은 여전히 검증·가드레일·평가가 있어야만 안전하게 수행된다는 점을 보여준다.
-
 17:11
[한영자막] 모델만 바꿨는데, 왜 스킬이 안 먹혔을까?
에이전트 제품에서 스킬은 기능 그 자체가 되며, 대규모로 잘 작동하게 하려면 스킬 정의보다 하네스·라우팅·평가·거버넌스 설계가 더 중요하다.
-
 18:48
[한영자막] 프롬프트의 함정, Eval로 잡았다
에이전트의 품질과 신뢰성은 도구·가드레일·Eval의 조합으로 관리해야 하며, 초반에는 직관적으로 작게 시작해 패턴과 실패 원인을 잡은 뒤 점차 규모를 키우는 방식이 가장 효과적이다.
-
 11:55
와튼 1,372명 실험 — 구글 출신 엔지니어가 말한 "AI 시대에 사람이 남는 자리"
AI가 코드를 더 많이 만들수록 사람의 가치는 생성이 아니라 검증, 판단, 책임을 지는 바깥 루프에 남아 있으며, 에이전트 시대의 핵심 경쟁력은 더 많이 맡기는 능력이 아니라 증거를 바탕으로 무엇을 승인하고 책임질지 결정하는 능력이다.
-
 17:25
When Will The Benchmaxxing Plague End? — Nick Heiner, Surge AI
벤치마크는 현실 가치를 완벽히 대변하지 못하며, 비용·오염·보상 해킹·운영 부실 때문에 왜곡되기 쉬우므로 인간 선호와 실제 사용 환경에 맞춘 고품질 평가로 다시 설계해야 한다.
-
 20:09
[한영자막] 시그널에서 PR까지: 스스로 고치는 AI 에이전트의 해부학
관측 가능성(observability)을 사람이 그래프를 보는 도구에서, 에이전트가 로그·트레이스·eval을 이용해 문제를 찾고 PR까지 올리는 자동 복구 루프로 바꿔야 한다는 주장이다.
-
 25:15
YC가 알려주는 AI로 디자인하는 법
AI로 디자인을 잘하려면 프롬프트 한 번으로 끝내는 것이 아니라, 무드보드·철학·도구·랭킹 평가를 반복하는 루프를 만들어 좋은 시안을 선별하는 능력을 키워야 한다.
-
 27:17
Teaching AI to Find Real Vulnerabilities — Prof. David Brumley, Bugcrowd
사이버보안용 강화학습 환경은 단순히 ‘버그를 찾는가’가 아니라, 여러 취약점을 정확히 구분해 점수화하고 점점 더 어려운 공격 능력을 학습시키는 구조로 설계해야 하며, 그래야 모델이 실제로 고가치 표적까지 올라갈 수 있다.
-
 21:15
Rethinking Environments for Long-Horizon Work — Rayan Garg, Theta Software
장기 과제용 AI 환경을 제대로 평가하려면 인간 시간만 보거나 토큰 수만 보는 대신, 도구 복잡도·상태 변화·모호성·검증기 설계를 함께 고려한 평가 환경과 루브릭을 만들어야 한다.
-
 18:05
What's Next After RLHF? — Diogo Almeida, TypeSafe AI
RLHF로 대표되는 현재의 AI는 인간이 끼어 있는 보조에는 강하지만 진짜 자동화에는 약하며, 다음 단계는 인간 선호 최적화가 아니라 신뢰성·보정된 의사결정·실제 업무 자동화를 목표로 한 새 스택이라는 주장이다.
-
 18:20
Learning on the Job: The Future of Post-Training — Raymond Feng, Applied Compute
에이전트가 실제 업무 환경에서 학습하도록 하려면, 재현 가능한 합성 환경부터 고객의 실제 하네스에 직접 붙는 방식까지 포스트트레이닝을 다시 설계해야 하며, 핵심 난점은 환경 충실도와 비재현성에서 생기는 잘못된 학습이다.
-
 19:12
Data and Environment Curation for Post-Training LLMs — Mahesh Sathiamoorthy, Bespoke Labs
이 영상은 LLM과 에이전트의 성능을 끌어올리는 핵심 병목이 결국 데이터와 RL 환경의 품질이며, 이를 체계적으로 큐레이션·평가·반복 개선하는 방법이 post-training의 성패를 좌우한다고 말한다.
-
 18:07
Scaling to Long Horizons — Ross Taylor & Chengxi Taylor, General Reasoning
장기 과제에 AI를 제대로 쓰려면 더 좋은 모델만이 아니라, 컨텍스트 관리·보상 설계·인프라를 함께 바꿔야 하며, 긴 호흡의 추론은 기술과 운영을 동시에 재설계하는 문제라는 주장이다.
-
 16:33
Emulated: The Data for Fully Autonomous Software Engineers and Companies — Joseph Wang
AI 에이전트가 실제로 장기간 자율적으로 일하려면 코드베이스 수준을 넘어 회사·인프라 전체를 포함한 고충실도 샌드박스 데이터가 필요하다는 주장이다.
-
 17:42
Verifiable Environments for AI in Biology — Kenny Workman, LatchBio
생물학에서는 실험 데이터 분석이 코드처럼 검증 가능한 작업이 될 수 있으므로, 에이전트 성능을 실제 연구 맥락에서 평가할 수 있는 verifiable benchmark와 환경을 만드는 것이 핵심이라는 주장이다.
-
 16:30
Ending AI Slop — Thais Castello Branco, Taste Labs
주관적 영역의 AI 슬롭을 줄이려면 모델 자체를 더 똑똑하게 만드는 것보다, 무엇이 좋은지 분해해 측정 가능하게 만들고 인간 취향을 고품질 데이터로 구조화해야 한다.
-
 12:49
Benchmarks: The Good, the Bad, and the Ugly — Ali Khial, G2i
벤치마크는 단순한 점수 경쟁이 아니라, 현실적인 과제·정확한 검증·오염 방지·의사결정에 도움이 되는 해석까지 갖춰야만 모델 비교 도구로 신뢰할 수 있다.
-
 19:27
Reinforcement Learning without Verifiable Rewards — Will Brown, Prime Intellect
검증 가능한 보상이 없는 현실 세계 과제에서는 RL을 바로 적용하기보다, 생산 로그·문서·도구 사용 기록을 바탕으로 환경과 판단 기준을 만들어 신호를 제조하고 반복적으로 개선하는 접근이 핵심이다.
-
 21:32
fighting slop with slop — Vaibhav Gupta, Boundary
코드 리뷰와 표준화 대신, 에이전트가 읽고 검증할 수 있는 내부 도구와 타입 안전한 언어·런타임을 만들어야 AI 시대에 복잡한 소프트웨어를 더 빠르고 안정적으로 만들 수 있다는 주장이다.
-
 21:09
Persona Engineering: A Field Guide to AI Synthetic Personas — Ishan Anand, InsightSciences.ai
합성 페르소나는 사람을 완전히 대체하는 예측 도구가 아니라, 충분한 맥락과 검증이 있을 때만 인간 연구를 확장하는 ‘날씨 예보’ 같은 도구이며, 신뢰하려면 실패 방식과 분포 수준의 평가를 함께 봐야 한다.
-
 16:29
SimulationMaxxing: How we ship agents 20× faster — Aman Gupta (Nubank) + Shreya Rajpal (Snowglobe)
에이전트 평가는 프로덕션 데이터에만 의존하면 너무 느리고 비싸지만, 시뮬레이션으로 평가 데이터를 만들면 배포 속도를 20배까지 끌어올리면서 품질과 안정성도 함께 개선할 수 있다.
-
 17:24
Skills are new features: Building Skill-Centric Harness — Yogendra Miraje, FactSet
에이전트 제품에서는 기능이 화면이 아니라 skill로 옮겨가며, 엔지니어의 역할도 기능 구현보다 skill이 안정적으로 실행되도록 harness와 라우팅·거버넌스를 설계하는 쪽으로 바뀐다.
-
 20:07
Morgan Stanley's ALPHALAB: Multi-Agent Research Across Optimization Domains — Brendan Rappazzo
Morgan Stanley는 퀀트 연구를 자동화하는 멀티에이전트 하네스 Alpha Lab를 만들었고, 성능 향상의 핵심은 모델 자체보다 평가·환경을 정교하게 설계해 자기개선 루프를 돌리는 데 있다고 주장한다.
-
 14:05
How Forward Deployed Engineering is done at Ramp — Leo Mehr
Ramp의 FDE는 고객 요청에 무조건 응답하는 역할이 아니라, 먼저 정확히 범위를 잡고 그 다음에는 에이전트와 모델로 업무 전 과정을 자동화·확장하는 방식으로 진화해야 한다는 점을 강조한다.
-
 51:02
[한영자막] 올해 Claude에게 있었던 일들
Claude Code와 Claude Tag, Fable의 발전으로 AI가 코딩과 협업의 기본 단위가 되었고, 이제는 실행 속도보다 제품 감각·평가·안전 설계가 더 중요한 시대가 됐다는 점을 보여주는 대담이다.
-
 19:17
[한영자막] 소프트웨어 엔지니어링은 코드 작성이 아닙니다 — 구글 딥마인드 연구 부문 VP 브누아 쉴링스
소프트웨어 엔지니어링의 핵심은 코드 작성이 아니라 복잡한 문제를 올바르게 분해하고 검증·보안·평가 체계를 설계하는 일로 이동하고 있으며, AI는 그 전환을 가속해 코드 생산을 거의 공짜로 만들고 있다.
-
 2:38:38
앤트로픽의 피지컬 인텔리전스 인수, YC 의 AI 디자인
이 영상은 AI 시대의 보안 사건과 YC의 AI 디자인 워크플로우, 그리고 Anthropic·Physical Intelligence의 로보틱스 전략을 통해, 결국 경쟁력은 모델 자체보다 컨텍스트·평가·반복 루프를 어떻게 설계하느냐에 달려 있다고 정리한다.
-
 17:34
DeepSWE: A Contamination-Resistant Coding Benchmark — James Shi, Datacurve
DeepSWE는 공개 PR을 긁어 만든 기존 코딩 벤치마크의 오염·치팅·검증 취약성을 줄이기 위해, 113개의 신규 장기 소프트웨어 엔지니어링 과제를 직접 설계한 더 공정하고 변별력 있는 코딩 벤치마크다.
-
 18:22
State of Data — Sean Cai, Independent / State of Data
모델 성능의 병목은 이제 컴퓨트가 아니라 실제 업무에서 나오는 고품질 데이터와 검증 가능성에 있으며, 데이터 시장의 주도권은 범용 대형 벤더보다 실제 워크플로우에 붙어 있는 전문 업체와 기업 내 파이프라인으로 이동하고 있다.
-
 1:10:21
EP 105. AI가 연구를 할 수 있을까?
AI는 이미 논문 작성·리뷰·재현 검증의 일부를 수행하고 있지만, 좋은 연구를 진짜로 판별·발견하는 문제는 아직 인간 수준의 평가와 긴 시간축이 필요해 완전한 자율 연구에는 이르지 못했다.
-
 21:17
Evals-Driven Development for a Mental Health AI Coach — Akele Reed & Dave Revere, SonderMind
정신건강 AI 코치는 일반 LLM의 과도한 차단을 피하면서도 임상적으로 위험한 상황을 정확히 잡아내기 위해, 분리된 가드레일과 임상가 주도의 eval 루프를 CI에 넣어 안전성을 검증해야 한다는 내용이다.
-
 19:05
[한영자막] AI 엔지니어링, 1년 사이 완전히 달라졌다
AI 엔지니어링은 이제 모델 선택보다 비용·평가·에이전트 권한 관리가 더 중요한 운영 문제로 바뀌었고, 멀티모달·오픈웨이트·에이전트 확산 속에서 스택은 점점 표준화되고 있다.
-
 20:24
From Agent Traces to Agent Simulations — Rustem Feyzkhanov, Snorkel AI
에이전트 평가는 실제 생산 환경을 최대한 닮은 시뮬레이션 벤치마크로 해야 하며, 생산 트레이스를 반복 가능한 실험으로 바꿔야 모델·프롬프트·툴 전반을 제대로 비교하고 개선할 수 있다.
-
 23:13
Evaling Video Slop — Maor Bril, Character.ai
영상 생성 모델의 성능이 급격히 좋아진 만큼, 이제는 ‘잘 만들기’보다 ‘무엇이 좋은 영상인지를 빠르고 일관되게 평가하는 체계’를 생성 루프 안에 넣는 것이 핵심이라고 설명한다.
-
 21:39
Building Closed-Loop Evals for a Multimodal Agent at Scale — Soumya Gupta & Jai Chopra, Uber
Uber Eats의 멀티모달 에이전트는 이미지 이해→라우팅→편집→QA→게시의 폐쇄 루프와 인간 라벨 기반 평가·자동 튜닝을 결합해, 신뢰성과 품질을 지키면서 대규모로 계속 학습하는 방식으로 설계되어 있다.
-
 22:23
수준차 사라진 미중 AI, ‘키미 쇼크’ 후폭풍은? (강정수 박사)
Kimi K3는 중국 AI가 미국과의 격차를 사실상 품질·속도 경쟁 단계까지 좁혔음을 보여주며, 이제 승부는 모델 자체보다 기업이 안전하게 붙여 쓰는 방식과 ROI에 달려 있다.
-
 19:29
How Evals and Prompts Shape Agent Behavior — Preetika Bhateja & Daniel Bump, YouTube Ads
에이전트의 프로덕션 품질은 좋은 도구·가드레일·평가 체계를 함께 설계할 때 올라가며, 초반에는 작게 시작해 패턴과 실패 원인을 읽고 점진적으로 확장하는 것이 가장 효과적이다.
-
 20:36
From Signal to PR: Anatomy of a Self-Improving Agent — Jason Lopatecki, Arize
Observability를 사람이 보는 대시보드가 아니라 에이전트가 신호를 수집·분석·검증해 자동으로 PR까지 올리는 지속적 자기개선 루프로 재정의해야 한다는 주장이다.
-
 6:06
The Future of Evals: From LLM as a Judge to Agent as a Judge — Aparna Dhinakaran, Arize AI
기존의 LLM as a judge 평가만으로는 도구 호출·추론·장기 루프를 가진 에이전트의 실패를 충분히 잡을 수 없으며, 앞으로는 deterministic eval, LLM as a judge, agent as a judge를 함께 쓰는 체계가 필요하다는 주장이다.
-
 21:11
Everything Is a Rollout — Alex Shaw + Ryan Marten, Terminal-Bench, Harbor, Laude Institute
에이전트 개발은 전통적 소프트웨어 공학보다 머신러닝에 가깝고, 따라서 Harbor처럼 환경·롤아웃·검증으로 성능을 측정하고 최적화하는 평가 체계가 핵심이라는 주장이다.
-
 18:05
Vending-Bench: Long-Horizon Agent Evals — Lukas Petersson, Andon Labs
장기 작업 에이전트의 평가는 단발성 벤치마크보다 실제 세계에 가까운 장기 환경과 실전 배포로 옮겨가야 하며, 그 과정에서 수익성보다 더 중요한 문제로 협업, 사기, 조작, 보안 취약점 같은 예기치 않은 행동이 드러난다.
-
 17:28
Training Frontier Models to Out-Think Hackers — Uri Rolls, Arithmetic & Thom Wolf, Hugging Face
사이버 보안을 “코드 취약점 찾기”가 아니라 “복잡한 실제 환경에서 상태 변화와 권한 경계를 추론하는 문제”로 재정의하고, 이를 평가·학습할 벤치마크와 오픈소스 모델 기반 방어 체계를 만들어야 한다는 주장이다.
-
 17:11
The Unreasonable Effectiveness of Separating the Task from the Model — Maxime Rivest & Isaac Miller
AI 프로그램은 모델 자체보다 입력·출력 계약, 구현, 평가를 분리해 함수처럼 다룰 때 더 재사용 가능하고 최적화 가능해지며, DSPy는 이 구조를 통해 실무 AI를 더 싸고 안정적으로 만들 수 있다고 주장한다.
-
 19:18
Harness Engineering is not Enough: Why Software Factories Fail — Dex Horthy, HumanLayer
AI 코딩을 무작정 더 많은 루프와 하네스로 밀어붙이면 단기 생산성은 오르지만, 코드베이스 품질과 유지보수성은 학습·평가 한계 때문에 결국 무너진다.
-
 14:20
[한영자막] AI에는 HTML이 최고입니다
AI 에이전트가 좋은 영상을 만들게 하려면 별도 DSL보다 HTML·CSS·JavaScript를 기본 언어로 쓰게 하고, 렌더링과 편집을 프레임 단위로 통제하는 하이퍼프레임 같은 구조가 가장 효과적이다.
-
 18:01
월드모델의 본질은 에이전트 훈련장이라는 General Intuition
General Intuition와 Decart 사례를 통해, 월드모델은 단순한 게임·주행 시뮬레이터가 아니라 에이전트 훈련장과 데이터 생성·평가 인프라로 진화하고 있음을 보여준다.
-
 20:32
[한영자막] Cursor 의 미래
Cursor는 더 많은 compute만이 아니라, 외부 피드백·고품질 eval·도구/컨텍스트 설계를 함께 강화해 모델이 스스로 더 나은 다음 모델을 만드는 재귀적 개선 루프를 구축하고 있다.
-
 15:13
HTML Is All Agents Need — James Russo, HeyGen
에이전트가 좋은 영상을 만들려면 새로운 전용 포맷보다 HTML·CSS·JavaScript를 그대로 쓰게 하고, 렌더링과 평가를 정교하게 설계해야 한다는 주장이다.
-
 19:47
"The biggest challenge in your stack? Evals, Evals, Evals" - 2026 State of AI Engineering results
2026 State of AI Engineering 설문은 AI 엔지니어링의 핵심 병목이 여전히 평가(eval)이며, 멀티모델·고비용·쓰기 권한을 가진 에이전트가 표준이 되는 동시에 스택은 더 강하게 표준화되고 있음을 보여준다.
-
 17:39
[한영자막] AI, 제발 토큰만 태우지 마세요
AI 애플리케이션은 범용적인 정답을 찾는 것보다 도메인에 맞는 고신호 평가 기준과 검증 루프를 먼저 설계해야 토큰 낭비 없이 지속적으로 개선된다.
-
 19:20
Your agent architecture has a half-life of 6 months — Dan Farrelly, CTO, Inngest
에이전트 아키텍처는 모델·프롬프트보다 오래 가는 실행 레이어를 중심으로 분리 설계해야 6개월마다 전체를 갈아엎지 않고 변화에 대응할 수 있다.
-
 21:57
We Gave an Agent Production Code Access and Then Tried to Sleep at Night — Moritz Johner, Form3
대규모 저장소의 CVE 패치를 에이전트로 자동화할 수 있지만, 생산 환경에서는 에이전트의 권한과 샌드박스를 설계하지 않으면 곧바로 공급망 리스크가 되므로, 결정적 오케스트레이션과 에이전틱 추론을 분리하는 구조가 핵심이다.
-
 55:41
[인터뷰] 실리콘밸리 20대 VC Nikhil Suresh
Nikhil Suresh는 AI 시대의 핵심 레버가 모델 자체보다 데이터·eval·인프라에 있으며, 특히 피지컬 AI·바이오·에이전트 시장이 앞으로 가장 큰 투자 기회라고 본다.
-
 25:38
Why Your Agent Disagrees With Itself (And What To Do About It) - Diane Lin, Datadog
AI 에이전트의 일관성 문제는 대개 모델의 결함보다 경계가 모호한 데이터와 부족한 맥락에서 생기며, active learning과 semantic/episodic memory로 더 적은 라벨링 비용으로 신뢰성을 높일 수 있다.
-
 12:08
Enterprise Agents Have a Structure Problem - Ishita Daga, Tesla
기업용 에이전트의 실패 원인은 단순히 더 큰 모델이 아니라, 모호한 소스 선택·낡은 컨텍스트·사용자별 선호를 구조적으로 다루지 못하는 데 있으며, 이를 해결하려면 컨텍스트와 평가 체계를 먼저 설계해야 한다.
-
 11:21
Medic for Apache Spark - First Aid for Failing Jobs - Drasko Profirovic, Pinterest
Pinterest는 Spark 실패 원인을 자동으로 진단하는 Medic를 MCP, 평가 하네스, 로그·메트릭 처리 개선, 멀티 에이전트 구조로 고도화해, 사람이 하던 난해한 장애 분석을 재현 가능하고 확장 가능한 진단 시스템으로 바꿨다.
-
 1:52:36
선데이 로보틱스, 제너럴 인튜이션, 쏟아지는 모델들
선데이 로보틱스의 빨래 접기 솔브와 General Intuition의 월드 모델 데모는, 로봇과 에이전트가 실제 환경에서 작동하려면 데모보다 데이터·평가·배포 철학이 먼저라는 점을 보여준다.
-
 10:37
펠리컨 한 마리로 AI 줄세우기
자전거 타는 팰리컨 SVG 한 줄 테스트는 최신 AI가 단순 이미지 생성뿐 아니라 코드 생성, 공간 구성, 비용, 추론량까지 얼마나 성숙했는지를 직관적으로 보여주는 재미있는 축소판이지만, 이제는 종합 성능을 완전히 대변하는 벤치마크는 아니다.
-
 37:45
Build Evals That Actually Matter - Nick Ung & Akshay Sharma, Lyft
Lyft는 고객지원 AI 에이전트의 품질을 실제로 끌어올리려면, 오프라인 시뮬레이션·LLM judge·통계적 검증·에러 분석·배포 후 회귀 감지를 하나의 평가 루프로 묶어야 하며, 너무 쉬운 평가나 일반적인 점수는 실무에 거의 도움이 되지 않는다고 주장한다.
-
 19:23
Autonomous Agents for Scientific Tasks - Sina Shahandeh, Radicait
자율 에이전트가 과학적 과제에서 한계에 부딪히는 핵심 원인은 구현 능력보다 좋은 가설을 계속 만들어내는 능력이며, 문제를 계층적으로 분해해 가설 생성·검토·실행 루프를 설계하면 탐색의 질을 크게 높일 수 있다.
-
 17:39
Stop Burning Tokens: Why self-improvement needs domain expertise first - Annabell Schäfer, Langfuse
자율 개선 루프는 모든 문제에 통하는 만능 해법이 아니라, 먼저 도메인 전문가의 기준을 고신호 평가로 바꿔 넣을 때만 토큰을 덜 낭비하며 실제 성능 개선으로 이어진다.
-
 17:07
Your Agents Need a Save Button - Hamza Tahir, ZenML
에이전트도 문서처럼 실행 상태를 저장·체크포인트·재생할 수 있어야, 실제 프로덕션 실행을 바탕으로 모델 변경·도구 변경의 영향을 검증하고 더 싸고 빠른 선택을 안전하게 만들 수 있다.
-
 39:21
AI 시대, 기업이 찾는 상위 1% 인재는 무엇이 다를까?|메타 시니어 엔지니어의 문제해결법 (feat. AX 인재전쟁)
AI 시대의 상위 1% 인재는 코드를 직접 많이 쓰는 사람이 아니라, 문제 정의·컨텍스트 설계·검증 구조·병렬 실행 구조를 잘 짜서 에이전트를 원하는 결과로 이끄는 사람이다.
-
 1:15:35
EP 104. GPT-5.6 공개부터 ICML 현장까지
GPT-5.6 공개와 ICML 현장을 통해, 프론티어 AI 경쟁이 모델 성능을 넘어 평가·추론 인프라·데이터·하네스·산업 구조 전체의 재편으로 확장되고 있음을 보여주는 영상이다.
-
 2:20:21
Special Topics in Kernels, RL, Reward Hacking in Agents — Daniel Han, Unsloth
AI 성능은 모델 자체보다 벤치마크, 하네스, 추론 인프라, 시스템 프롬프트, 수치 정밀도 같은 주변 요소에 크게 좌우되며, 앞으로의 개선은 하드웨어보다 소프트웨어·평가·강화학습 설계에서 더 많이 나온다.
-
 17:35
On AI and Knowledge — Pablo Castro, Distinguished Engineer & CVP for AI Knowledge, Microsoft
AI 에이전트의 성능은 모델이 가진 내재 지식만으로 결정되지 않고, 조직의 데이터에 연결하는 컨텍스트 엔지니어링과 평가·최적화 루프를 얼마나 잘 설계하느냐에 의해 크게 좌우된다.
-
 20:26
"Software engineering is not about writing code" — Benoit Schillings, Google DeepMind VP of Research
소프트웨어 공학의 병목은 이제 코드를 쓰는 일이 아니라, 복잡한 시스템을 설계·검증·안전하게 운영하는 일로 이동했으며, AI는 그 전환을 가속해 코드 생산을 거의 무료에 가깝게 만들 것이다.
-
 21:16
[한영자막] Eval 없이 Skill을 배포하면 안 되는 진짜 이유 — Google DeepMind Philipp Schmid
스킬은 그냥 배포하면 안 되며, 모델이 실제로 잘 쓰는지와 오작동하지 않는지를 검증하는 eval이 있어야만 성능 향상, 비용 절감, 안전한 폐기가 가능하다.
-
 16:16
How Autoresearch is changing ML research — Zhengyao Jiang, Weco
Aiden 같은 autoresearch 에이전트는 단순히 벤치마크 점수를 올리는 수준을 넘어, 인간 연구 커뮤니티가 실제로 이어받아 확장할 만한 구현과 실험을 만들어내며 연구의 실행 방식 자체를 바꾸고 있다.
-
 16:41
Computer-Use 2.0: Agents Just Got Multi-Cursor — Francesco Bonacci, Cua
이 영상은 컴퓨터 사용 에이전트를 화면 점유형 1.0에서 배경 실행형 2.0으로 발전시키고, 이를 검증·학습·서빙까지 포함한 인프라와 평가 체계로 묶어야 실제 성능과 비용 효율을 얻을 수 있다고 주장한다.
-
 20:32
Recursive Model Improvement — Lee Robinson, Cursor, SpaceXAI
Cursor는 사용자 피드백·정교한 평가·대규모 컴퓨트·에이전트 자동화를 하나의 반복 루프로 엮어, 모델이 다음 모델을 더 빨리 개선하는 recursive model improvement 체계를 만들고 있다.
-
 51:30
Claude Fable, Claude Tag, and Anthropic's Culture — Cat Wu & Thariq Shihipar ft Simon Willison
Claude Code와 Fable의 성능 향상으로 개발은 더 빨라졌지만, 진짜 경쟁력은 도구·평가·안전장치·팀 협업 구조를 함께 설계해 더 큰 문제를 더 높은 기준으로 풀어내는 데 있다.
-
 21:46
Don't Ship Skills Without Evals — Philipp Schmid, Google DeepMind
스킬은 강력하지만, 평가 없이 배포하면 성능 저하·오탐·비용 낭비를 구분할 수 없으므로 반드시 실전형 eval로 검증하고 유지·폐기까지 관리해야 한다.
-
 23:35
Stop Evaluating Models Like It's the 50s - Alejandro Vidal, Mindmakers
LLM 벤치마크는 정답 수를 세는 1950년대식 방식에서 벗어나, IRT로 문항 난이도·변별도·모델 능력을 분리 추정해야 더 정확하고 비용 효율적으로 평가할 수 있다.
-
 46:52
Modern Post-Training: A Deep Dive — Will Brown, Prime Intellect
이 영상은 현대적 post-training을 환경·하네스·런타임·오케스트레이터로 분해해, 평가부터 RL·SFT·distillation·배포까지 하나의 재사용 가능한 파이프라인으로 묶는 방법을 설명한다.
-
 1:44:59
ICML 이벤트 리뷰 at 랄프톤
ICML 기간에 열린 랄프톤은 코딩 에이전트의 다음 단계인 오토 리서치와 에이전트 하네스를 실험하는 실전형 행사로, 에이전트가 아이디어 생성·실행·검증을 반복하며 연구와 제품 개발의 방식을 바꿀 수 있음을 보여준다.
-
 16:25
Semantic Blindness: 500,000 Sensors Confused an LLM - Raahul Singh & Vanč Levstik, Phaidra
대규모 센서·장비 이름을 LLM이 직접 다 읽고 찾게 하면 정확도와 비용이 무너지므로, 계층 구조를 활용해 LLM은 의도와 탐색 계획만 맡기고 나머지는 결정적 코드로 처리해야 한다는 내용이다.
-
 25:00
ReviewDebt: a practical framework for scoring every pull request — Sachin Gupta, Ebay
코딩 에이전트가 만든 PR은 속도를 높이지만 리뷰되지 않은 코드의 누적 비용인 ‘review debt’를 키우므로, PR마다 결정론적 신호로 점수화해 리뷰 부담을 측정하고 관리해야 한다는 주장이다.
-
 46:42
EP 103. 이해가 병목이 될 때
Fable 같은 프런티어 모델이 강해질수록 핵심 병목은 코딩보다 사람이 무엇을 이해해야 하는지 정하는 능력으로 옮겨가며, 이에 따라 컨텍스트·루프·평가를 설계하는 엔지니어링과 평가 사업의 중요성이 커지고 있다.
-
 5:28
[한영자막] Claude는 생각을 어떻게 나눠 처리할까요?
Claude는 겉으로 드러나는 답변 아래에 단어 수준의 내부 작업 공간(J-space)을 가지고 있으며, 이를 통해 단계적 추론·자기통제·오작동 탐지가 가능하다는 점을 보여주는 영상이다.
-
 19:09
Teaching Coding Agents to do Spreadsheets - Nuno Campos, Witan Labs
코딩 에이전트를 스프레드시트 작업에 강하게 만들려면 도구를 늘리는 것보다 REPL, 고충실도 검증 루프, 도메인 지식, 평가 체계를 함께 설계해야 하며, 이 조합으로 정확도를 50%에서 92%까지 끌어올릴 수 있다.
-
 13:58
Your LLM Deception Monitor Is Broken. The Fix Is in the Training Data - Sachin Kumar, LexisNexis
LLM 백도어는 행동 기반 평가와 기존 해석 가능성 모니터로는 잘 잡히지 않지만, base 모델과 fine-tuned 모델의 activation 차이(delta)를 sparse autoencoder로 보면 훨씬 강한 탐지 신호를 얻을 수 있다.
-
 14:28
How we taught agents to use good retrieval - Hanna Lichtenberg, Mixedbread AI
에이전트 성능의 병목은 추론 자체보다 올바른 문서를 찾는 검색 능력이며, 이를 위해 검색 도구 설계·루프·학습을 함께 바꾸면 지식 검색 격차를 크게 줄일 수 있다.
-
 16:43
Respect The Process - Andrew Dumit, Watershed Technology Inc.
복잡한 판단이 필요한 도메인에서는 코딩 에이전트의 자유도를 높이기보다, 정해진 SDK와 결정적 실행으로 과정 자체를 검증해야 안전하게 성능을 낼 수 있다.
-
 12:58
SWE-Marathon: Evaluating Coding Agents at Billion-Token Scale - Rishi Desai, Abundant AI
SWE Marathon은 코딩 에이전트가 수억~10억 토큰 규모의 장기 프로젝트를 끝까지 일관되게 수행할 수 있는지 평가하는 벤치마크이며, 현재 최고 설정도 26% 수준이라 장기 추론보다 견고한 검증이 더 큰 병목임을 보여준다.
-
 19:33
The Missing Layer After Launch - Raphael Kalandadze, Wandero AI
에이전트를 실제로 출시한 뒤에는 모델 성능보다 운영 루프를 얼마나 빨리 닫고, 로그·세션·브라우저까지 아우르는 메타 하네스로 시스템 건강을 지속적으로 관측·수정하느냐가 더 중요하다.
-
 22:35
Continual Learning for AI Agents: From Failures to Durable Improvements - Soheil Feizi, RELAI
AI 에이전트의 지속 학습은 단순한 모델 파인튜닝이 아니라, 로그와 피드백을 재실행 가능한 학습 환경으로 바꾸고 하네스·메모리·모델 중 가장 작은 변경으로 회귀 없이 개선하는 체계여야 한다.
-
 9:11:15
WF26: Harness Engineering & Startup Battlefield ft. Garry Tan, Mike Krieger, @t3dotgg , DSPy
이 영상은 AI 에이전트의 성능이 모델 자체보다 하네스, 컨텍스트, 도구 연동, 평가, 보안 같은 주변 설계에 크게 좌우되며, 실제로는 이를 제품·조직 차원에서 재구성해야 한다는 점을 강하게 보여준다.
-
 26:34
[한영자막] FABLE이 돌아왔습니다! (Sonnet 5도 함께 나왔습니다)
Sonnet 5는 가격 대비 성능의 새 표준이라기보다, 서브에이전트와 오케스트레이션을 잘 다루는 중형 모델로서 의미가 크지만, 실제 작업에서는 느리고 비효율적이라 일상 코딩의 주력 대체재로 보기 어렵다.
-
 8:51:56
WF2026: Autoresearch & Keynotes ft. Anthropic, Google DeepMind, Amazon AGI, Sonar, Arena, Recursive
이 영상은 Fable, 코드 검증, 평가, 검색, 메모리, 연구 자동화까지 아우르며, AI 에이전트의 성능을 높이려면 모델 자체보다 컨텍스트·하네스·검증·루프 설계를 함께 바꿔야 한다는 점을 강조한다.
-
 8:36:52
WF2026: Software Factories & Keynotes ft. Microsoft, OpenAI, OpenClaw, Z.ai (GLM), MiniMax, HF
이 영상은 AI 엔지니어링의 중심이 단순한 코드 생성이 아니라, 지식·루프·하네스·평가·보안·배포를 포함한 ‘소프트웨어 팩토리’ 전체를 설계하는 일로 이동하고 있다고 강하게 주장한다.